国防契約巡る離職運動でOpenAIが組織的危機
「QuitGPT」運動と組織の分断
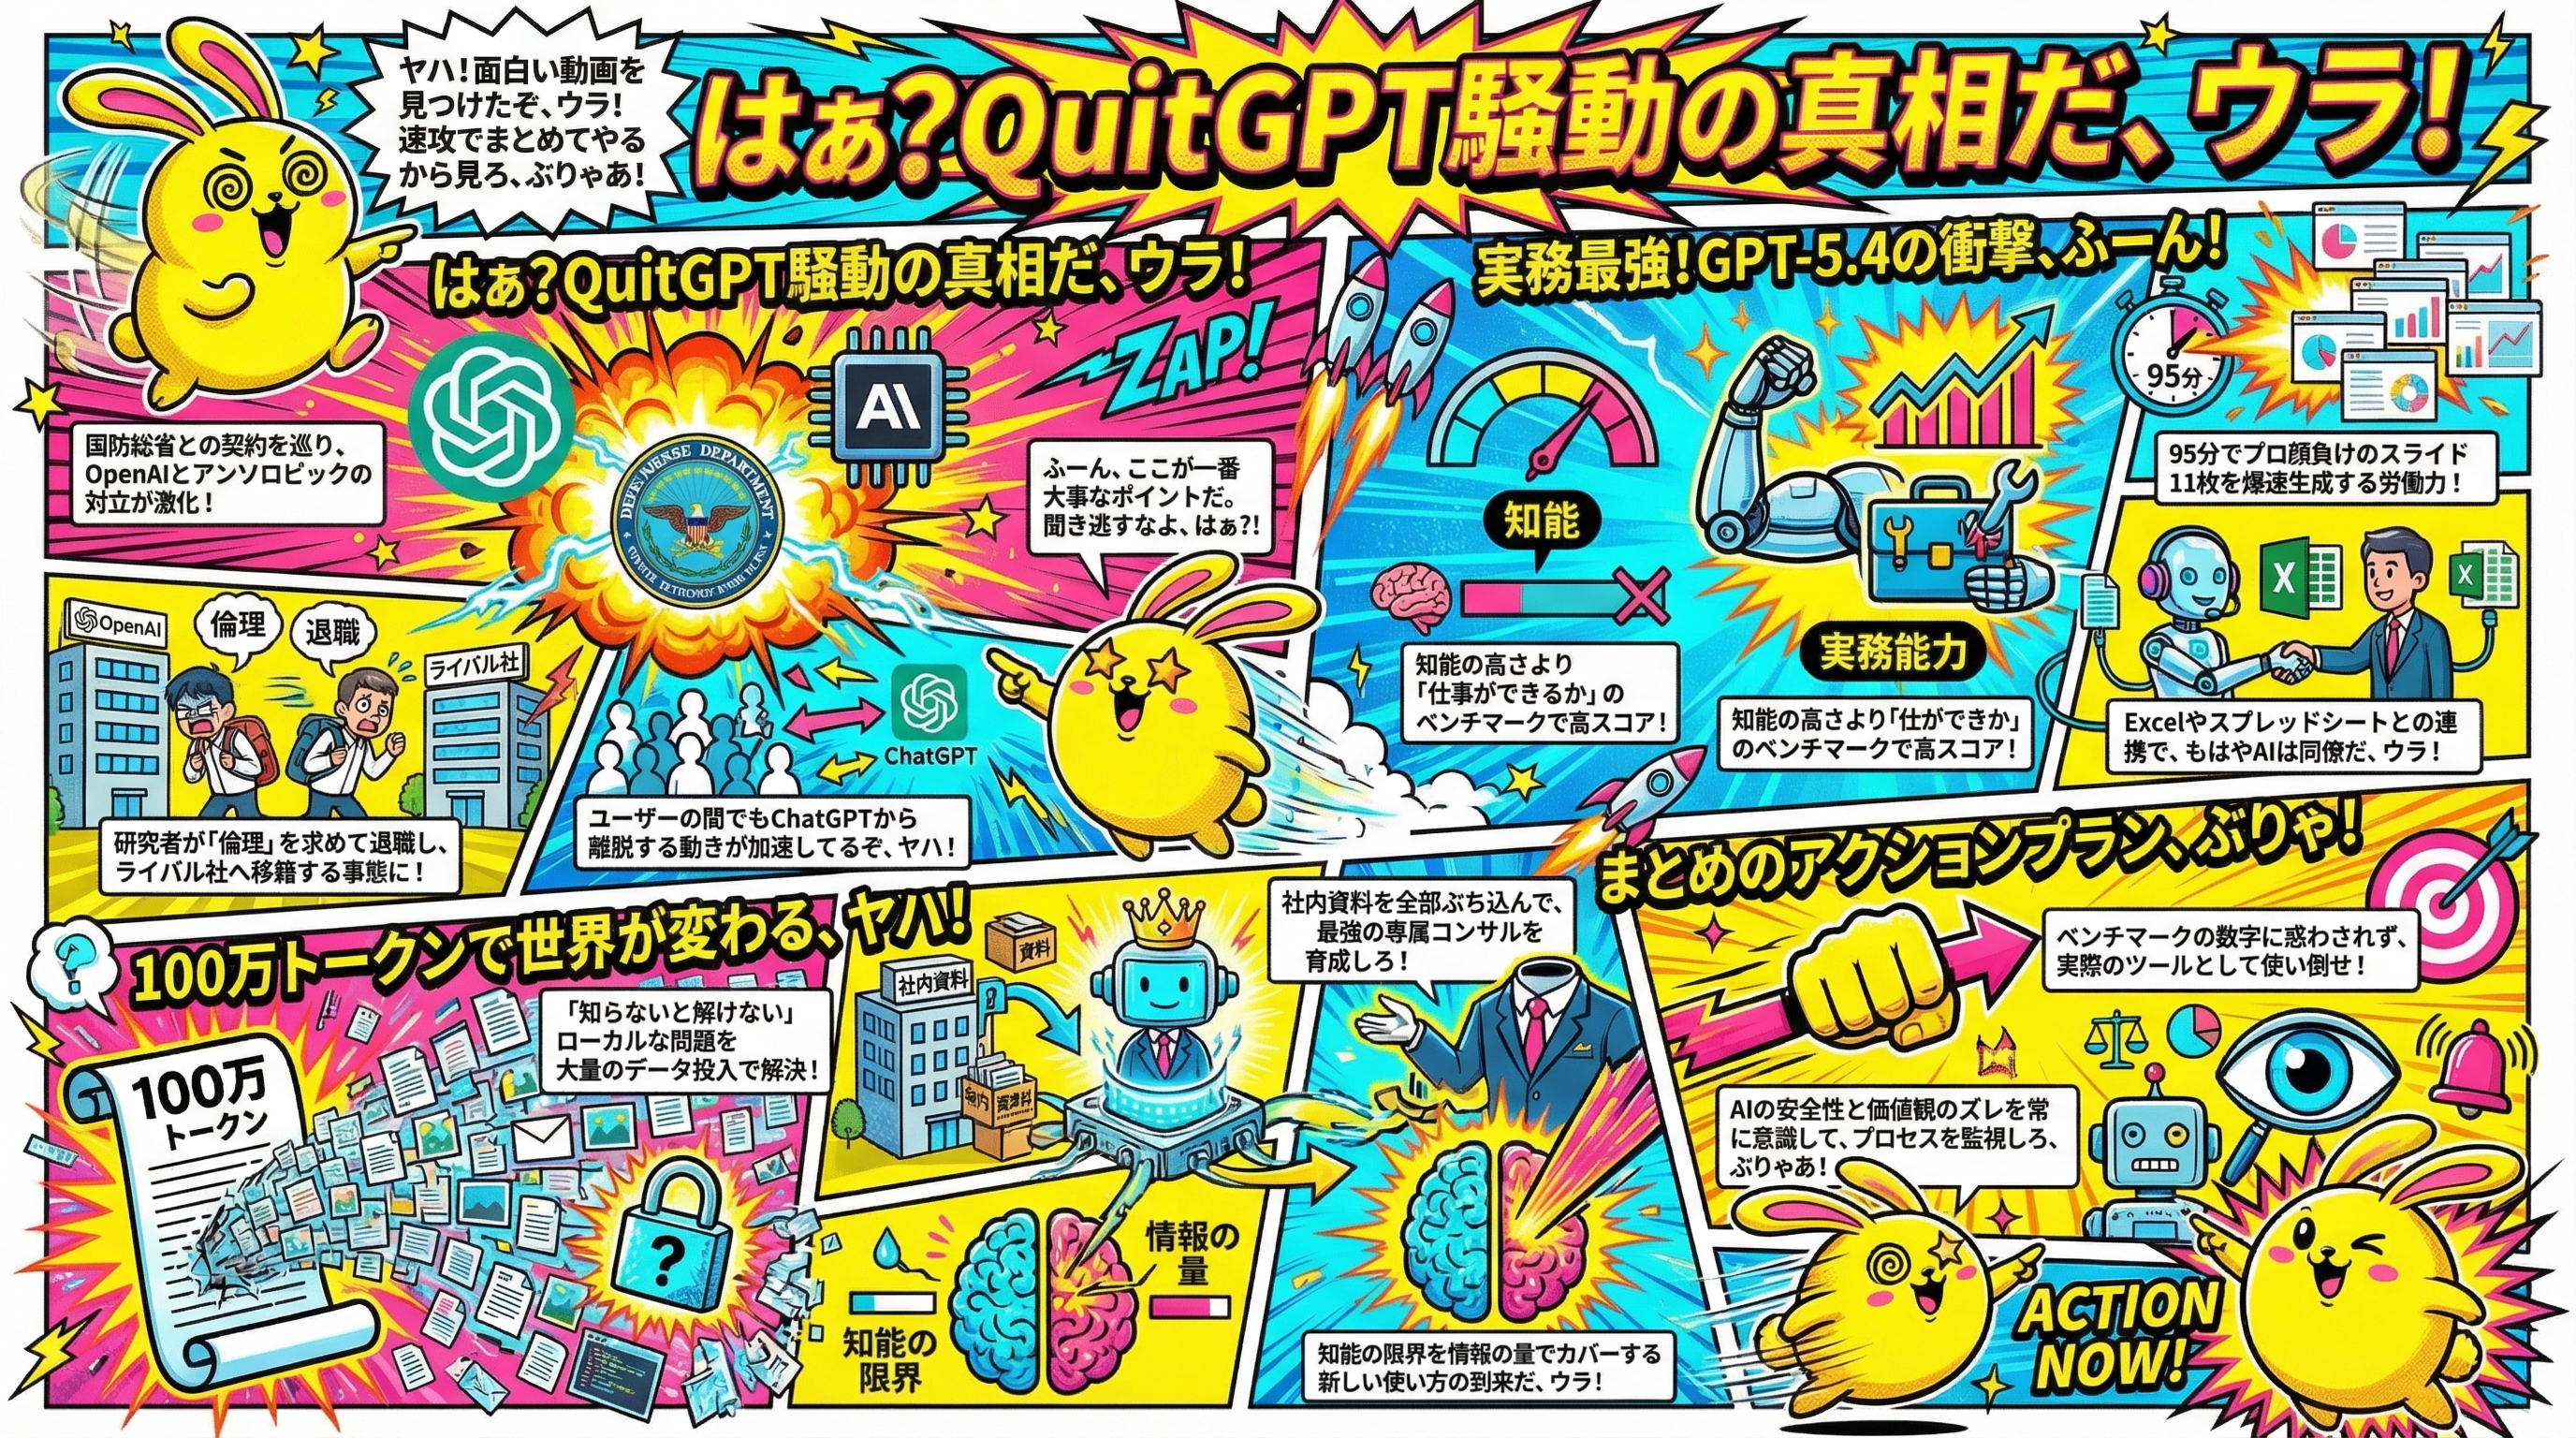
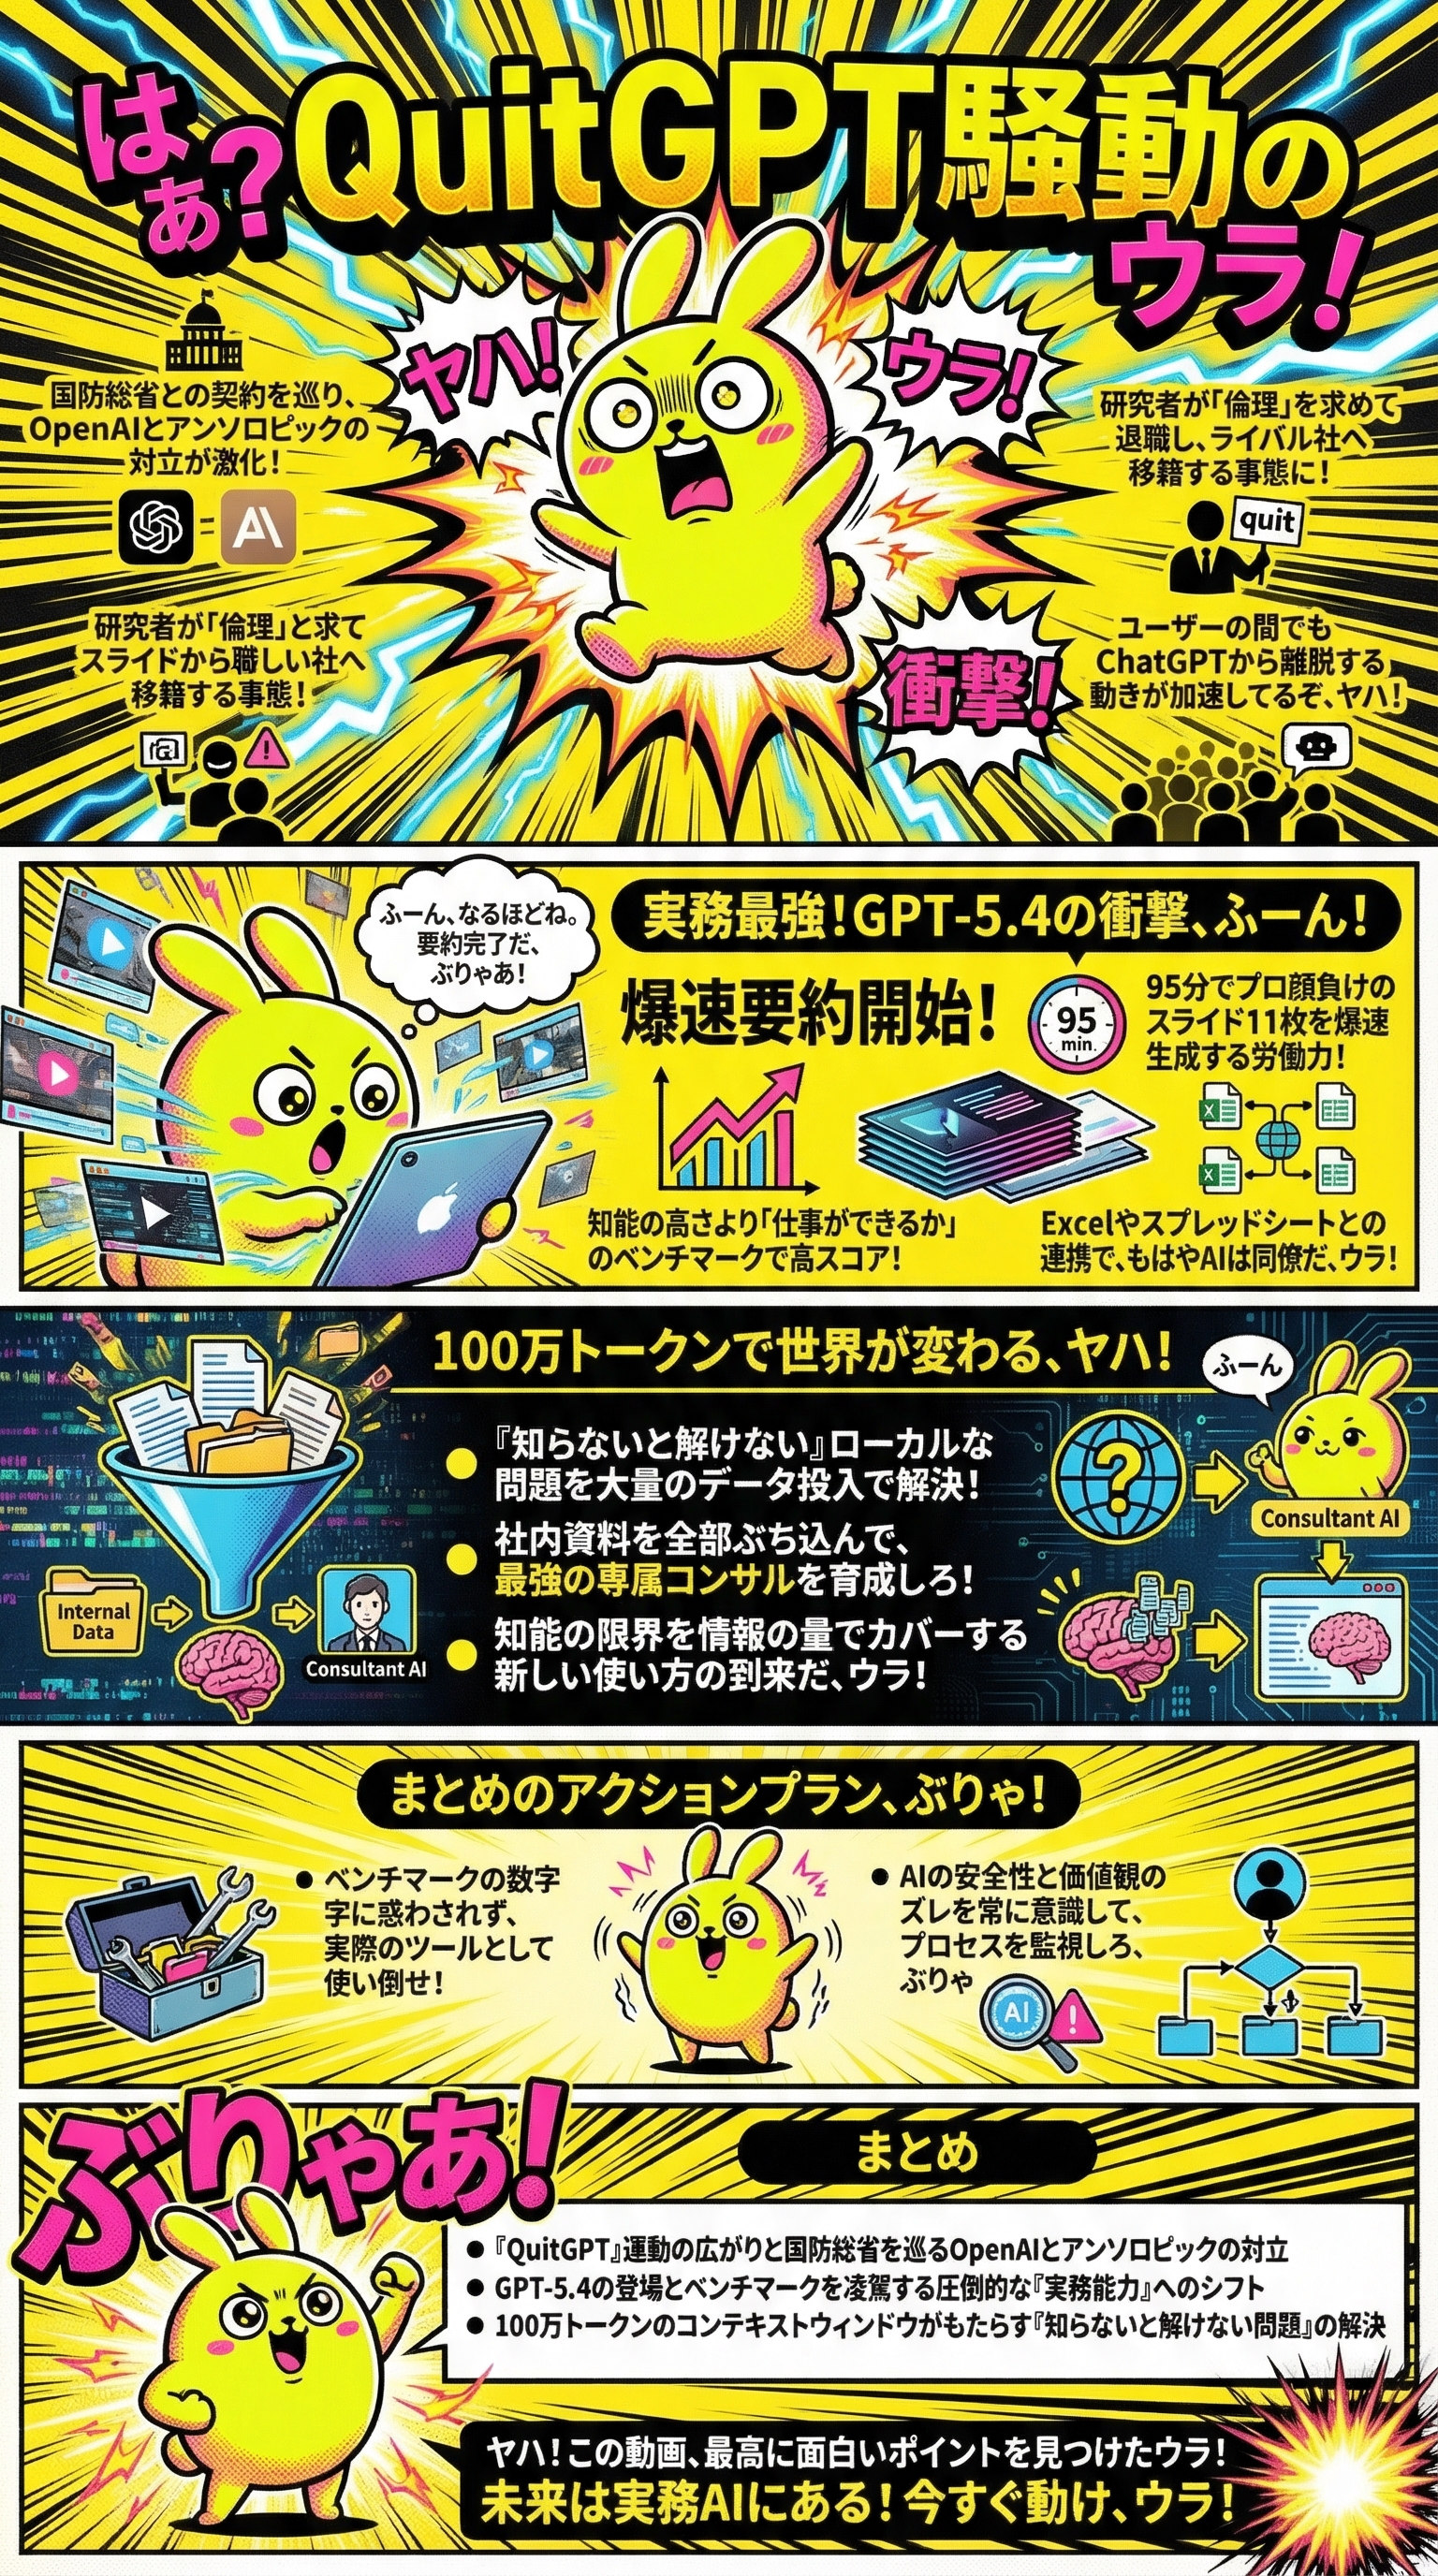
OpenAIがアメリカ国防総省と契約を締結したことで、同社に対する「QuitGPT」と呼ばれる大規模な解約運動が巻き起こっています。
この運動には400万人を超える署名が集まっており、単なるユーザーの反発にとどまりません。
社内の研究者がAnthropic (アンソロピック) へ移籍するなど、深刻な組織の分断を招いているのが現状です。
Anthropicとの対比と倫理的対立
背景には、競合であるAnthropicが「自律型兵器や大規模監視への不使用」という信念を崩さず、国防総省との契約を打ち切ったことがあります。
その契約をOpenAIが「奪い取った」形に見えることが、内外からの批判を強める要因となりました。
OpenAIを退職した研究者のマックス・シアツ (Max Siyats) 氏らがAnthropicへ合流している事実は、AI業界における「倫理 vs 利益」の対立を象徴しています。
研究者が抱く懸念の正体
この問題について、AI研究者の今井翔太氏は以下のように分析しています。
- 研究者の自尊心多くのAI研究者は純粋な知能の探求を目的としており、破壊的な目的への転用を強く拒絶します。
- 学術界との関係大学や研究機関は軍事利用に対して厳しい姿勢をとることが多く、将来のキャリアに影響するリスクがあります。
- 意思決定の不透明さアンスロピックが守ろうとした「一線」をOpenAIが緩和した可能性があり、それが反発を呼んでいます。
このような状況下で、サム・アルトマン (Sam Altman) 氏は「政府との協力は社会にとって必要だ」と主張していますが、その言葉が研究者たちの不信感を拭い去るには至っていないようです。
企業としての成長を優先するOpenAIと、思想を重んじるAnthropicの対比が鮮明になっています。
最終的に、この分断がOpenAIの長期的な開発能力にどのような影響を与えるかが注目されます。
優秀な人材の流出は、技術的なリードを失う直結の要因になりかねないからです。
実務特化型モデル「GPT-5.4」が見せたベンチマークの限界
実務能力へのシフト
最新モデルであるGPT-5.4は、従来の知能指数を競うフェーズから、実際の業務を完遂する「実務能力」へ大きく舵を切ったモデルです。
特にプレゼンテーション資料の自動生成やスプレッドシートの操作において驚異的な成果を上げており、これまでの「賢いチャットボット」という枠組みを完全に超え始めています。
既存ベンチマークの形骸化
これまでAIの性能評価に使われてきたMMLUやGDP-Evalといったベンチマークは、あまりの進化の速さに「形骸化」しつつあります。
GPT-5.4は、人間のエキスパートが解くような高度なタスクを8割以上の精度でクリアしていますが、それがそのまま「AGI (汎用人工知能)」に近いことを意味するわけではありません。
知能の高さと、道具としての便利さは別物だということが浮き彫りになっています。
進化した具体的な実務機能
具体的な実務能力の進化については、以下のステップで確認できます。
- 1複雑なプロンプトへの対応抽象的な指示から、背景にある文脈を読み取ってアウトプットの方向性を定めます。
- 2長時間におよぶ生成プロセス約90分以上の時間をかけて10枚以上の高品質なスライドを構成するなど、粘り強い作業が可能です。
- 3外部ツールとのシームレスな連携Excelや金融サービス向けのプラグインを通じ、専門的なデータを直接処理します。
今井翔太氏によれば、GPT-5.4の最大の特徴は「100万トークンのコンテキストウィンドウ」です。
これにより、社内マニュアルや膨大な論文、ソースコードを一気に読み込ませることが可能になり、特定の環境における「ローカルルール」を理解した上での業務遂行が可能になっています。
知能を高めることよりも、実務のボトルネックを解消することにリソースが割かれています。
これは、OpenAIが研究機関から実利を求める企業へと完全に変貌した証拠とも言えるでしょう。
この転換により、私たちは「AIに何を聞くか」ではなく「AIに何を任せるか」という、エージェントとしての活用を本格的に考える段階に入りました。
GPT-5.4は実務能力の向上に特化しており、既存の知能評価の枠組みを超えた進化を遂げています。
サム・アルトマンとダリオ・アモデイの思想的決裂
二人のリーダーの根本的な対立
OpenAIを率いるサム・アルトマン氏と、AnthropicのCEOであるダリオ・アモデイ (Dario Amodei) 氏の対立は、現在のAI業界の方向性を決める決定的な要素です。
二人の対立は単なるビジネス上の競合ではなく、AIが社会、そして国家とどう向き合うべきかという「根源的な思想の差」に起因しています。
ダリオ・アモデイの理想主義
ダリオ・アモデイ氏は元々OpenAIに所属していましたが、AIの安全性を巡る方針の違いから同社を去り、Anthropicを設立しました。
彼は「ロマン主義」とも言える強い信念を持っており、軍事利用や監視社会への加担を断固として拒否する姿勢を貫いています。
その結果、政府からの契約を打ち切られ、サプライチェーンリスクに指定されるという実務的な大打撃を受けましたが、その信念は揺らいでいません。
サム・アルトマンのリアリズム
対照的に、サム・アルトマン氏は「リアリスト」としての側面が強いビジネスマンです。
彼の発言は戦略的に変遷することが多く、国防総省との契約についても「政権が誰であれ、政府との協力はやめるべきではない」と極めて現実的な論理を展開しています。
| 特徴 | サム・アルトマン (OpenAI) | ダリオ・アモデイ (Anthropic) |
|---|---|---|
| 基本スタンス | リアリズム・利益最大化 | 理想主義・安全性重視 |
| 政府との関係 | 積極的に協力・契約獲得 | 監視への利用を拒否・対立 |
| 背景 | ビジネス・資金調達のプロ | 研究者・安全性研究の先駆者 |
今井氏は、企業のトップがどのような姿勢を持つかが、そのAIモデルの性格(ガードレール)に反映されると指摘しています。
Anthropicのモデルが「慎重すぎる」と言われる一方でOpenAIが「使い勝手が良い」とされるのは、このトップの思想の差が、そのままアルゴリズムの調整に影響しているからです。
結局のところ、どちらが勝利するかは「市場が何を求めるか」にかかっています。
しかし、国家の安全保障が絡む現在の状況では、個人の信念だけでは制御できない巨大な力が働き始めているのも事実です。
この巨大な対立構造こそが、現代のAI開発レースの複雑さを生み出している主因と言えるでしょう。
両者の思想的な決裂は、AIの安全性と利便性のどちらを優先するかという、市場への大きな問いかけとなっています。
リーダーの思想の違いがモデルの性格を決定づけており、この対立がAI開発の方向性に大きな影響を与えています。
安全性こそが次世代AIの「最強の武器」になる理由
エージェント化に伴う安全性の重要性
これまでのAI開発において、「安全性(アラインメント)」は性能追求を妨げる足かせと見なされる傾向にありました。
しかし、AIが人間に代わって複雑なタスクをこなす「エージェント化」が進むにつれ、安全性こそが最も重要な性能指標になりつつあります。
なぜなら、どれほど賢くても、勝手にファイルを消したりセキュリティを無効化したりするAIを、人間は安心して使うことができないからです。
AIアラインメントと信頼の構築
特に、AIにメールの送信や銀行口座の操作、プログラミングなどを任せる場合、人間がすべてのプロセスを監視することは不可能です。
ここで重要になるのが、「人間の価値観や常識をどれだけAIが内面化しているか」という点です。
これを研究する分野が「AIアラインメント」であり、Anthropicはこの分野で先行することで、実務利用における信頼性を獲得しようとしています。
安全性がもたらすビジネスメリット
安全性を高めることは、以下の3つのメリットをビジネスにもたらします。
- リスクの回避警察への脅迫状を勝手に送る、不適切な投稿をするといった「一発アウト」の事故を防ぎます。
- 信頼による権限移譲人間が安心してAIに特権的なアクセス権を与えられるようになり、自動化の範囲が広がります。
- ユーザー満足度の向上「できない」と拒絶するのではなく、人間の意図を汲み取った適切なサポートが可能になります。
今井氏は、中学生にPC作業を頼むとき、私たちが「警察に脅迫状を送らないだろう」と無意識に信頼しているのと同様のレベルまで、AIを引き上げる必要があると説いています。
現在のAIは、ある部分では天才的でありながら、ある部分では驚くほど常識を欠いています。
このギャップを埋めることこそが、開発レースの勝負所です。
安全性を犠牲にした性能向上は、もはや実務の世界では通用しなくなっています。
信頼を勝ち取った企業だけが、ユーザーのPCやスマートフォンの深い部分まで入り込むことができるのです。
安全性は単なる倫理の問題ではなく、AIが社会のインフラになるための必須条件であり、競争力の源泉そのものです。
次世代のAI開発において、この安全性をいかに担保するかが、企業の命運を分ける最強の武器となります。
AIが社会インフラとして普及するためには、安全性を通じた信頼の構築が不可欠な要素となります。
AlphaGoから10年:人間からの卒業と自己発展の未来
AlphaGoが示した「人間超え」の本質
Google DeepMind (グーグル・ディープマインド) が開発した囲碁AI、AlphaGo (アルファ碁) が世界トップの棋士に勝利してから10年が経過しました。
この出来事は、当時のディープラーニングが「人間の頂点を超えた」という衝撃を世界に与えましたが、その本質的な意義は、AIが「人間からの卒業」を果たしたことにあります。
自己学習による進化のプロセス
AlphaGoの進化過程(AlphaGo LeeからAlphaGo Zeroへ)が示したのは、人間の対局データから学ぶよりも、AI同士が自己対戦(セルフプレイ)を通じて学ぶ方が、遥かに強くなるという事実です。
これは、データが枯渇しつつある現在のLLM開発においても、極めて重要な示唆を与えています。
強化学習とディープラーニング、そして探索アルゴリズムの三位一体によって生まれたAlphaGoは、以下の要素をAI研究に定着させます。
- 1計算資源の投下(スケーリング)膨大なCPUとGPUを連携させれば、特定領域で人間に勝てることを証明しました。
- 2自己改善の仕組み人間が教えるのではなく、AIが自分で試行錯誤して最適な解を見つけるプロセスを確立します。
- 3明確な評価指標の重要性囲碁のように「勝ち負け」がハッキリしているタスクは、AIが自己ループ的に成長しやすい環境を提供しました。
自律的な知能向上への移行
現在のLLMにおいて、プログラミングや数学の分野が飛躍的に伸びているのは、AlphaGoと同様に「答えの正誤」が機械的に判定可能だからです。
今井氏は、今後のAI開発において、人間の「お気持ち」や主観的な基準に頼らない、自己発展的な学習プロセスをいかに構築できるかが鍵になると予測しています。
AlphaGoから始まった「スケーリングの思想」は、今やChatGPTやGeminiといった巨大モデルに受け継がれていますが、次の10年は「いかに人間が関与せず、AIが自律的に知能を高め、かつ安全性を保つか」という、より高度なフェーズへ移行していくことになるでしょう。
10年前の勝利は終わりではなく、AIが人間の介助なしに知能を紡ぎ出す時代の幕開けだったのです。
これからのAI開発は、単なる情報の蓄積から、自律的な知の探求へと進化していくことが期待されています。
AIが自律的に知能を高める時代の幕開けにより、人間を介さない自己発展的な学習プロセスの構築が今後の鍵となります。
