こんにちは、まなびクマだよ。
この記事では、人工知能の心臓部ともいえる「ニューラルネットワーク」が、具体的にどんな仕組みで動いているのかを一緒にのぞいていこうね。
ニューロンが保持する活性化という数値
ニューロンの正体
ニューラルネットワークの最も小さな単位であるニューロンは、単なる0から1までの数字を保持する入れ物なんだ。
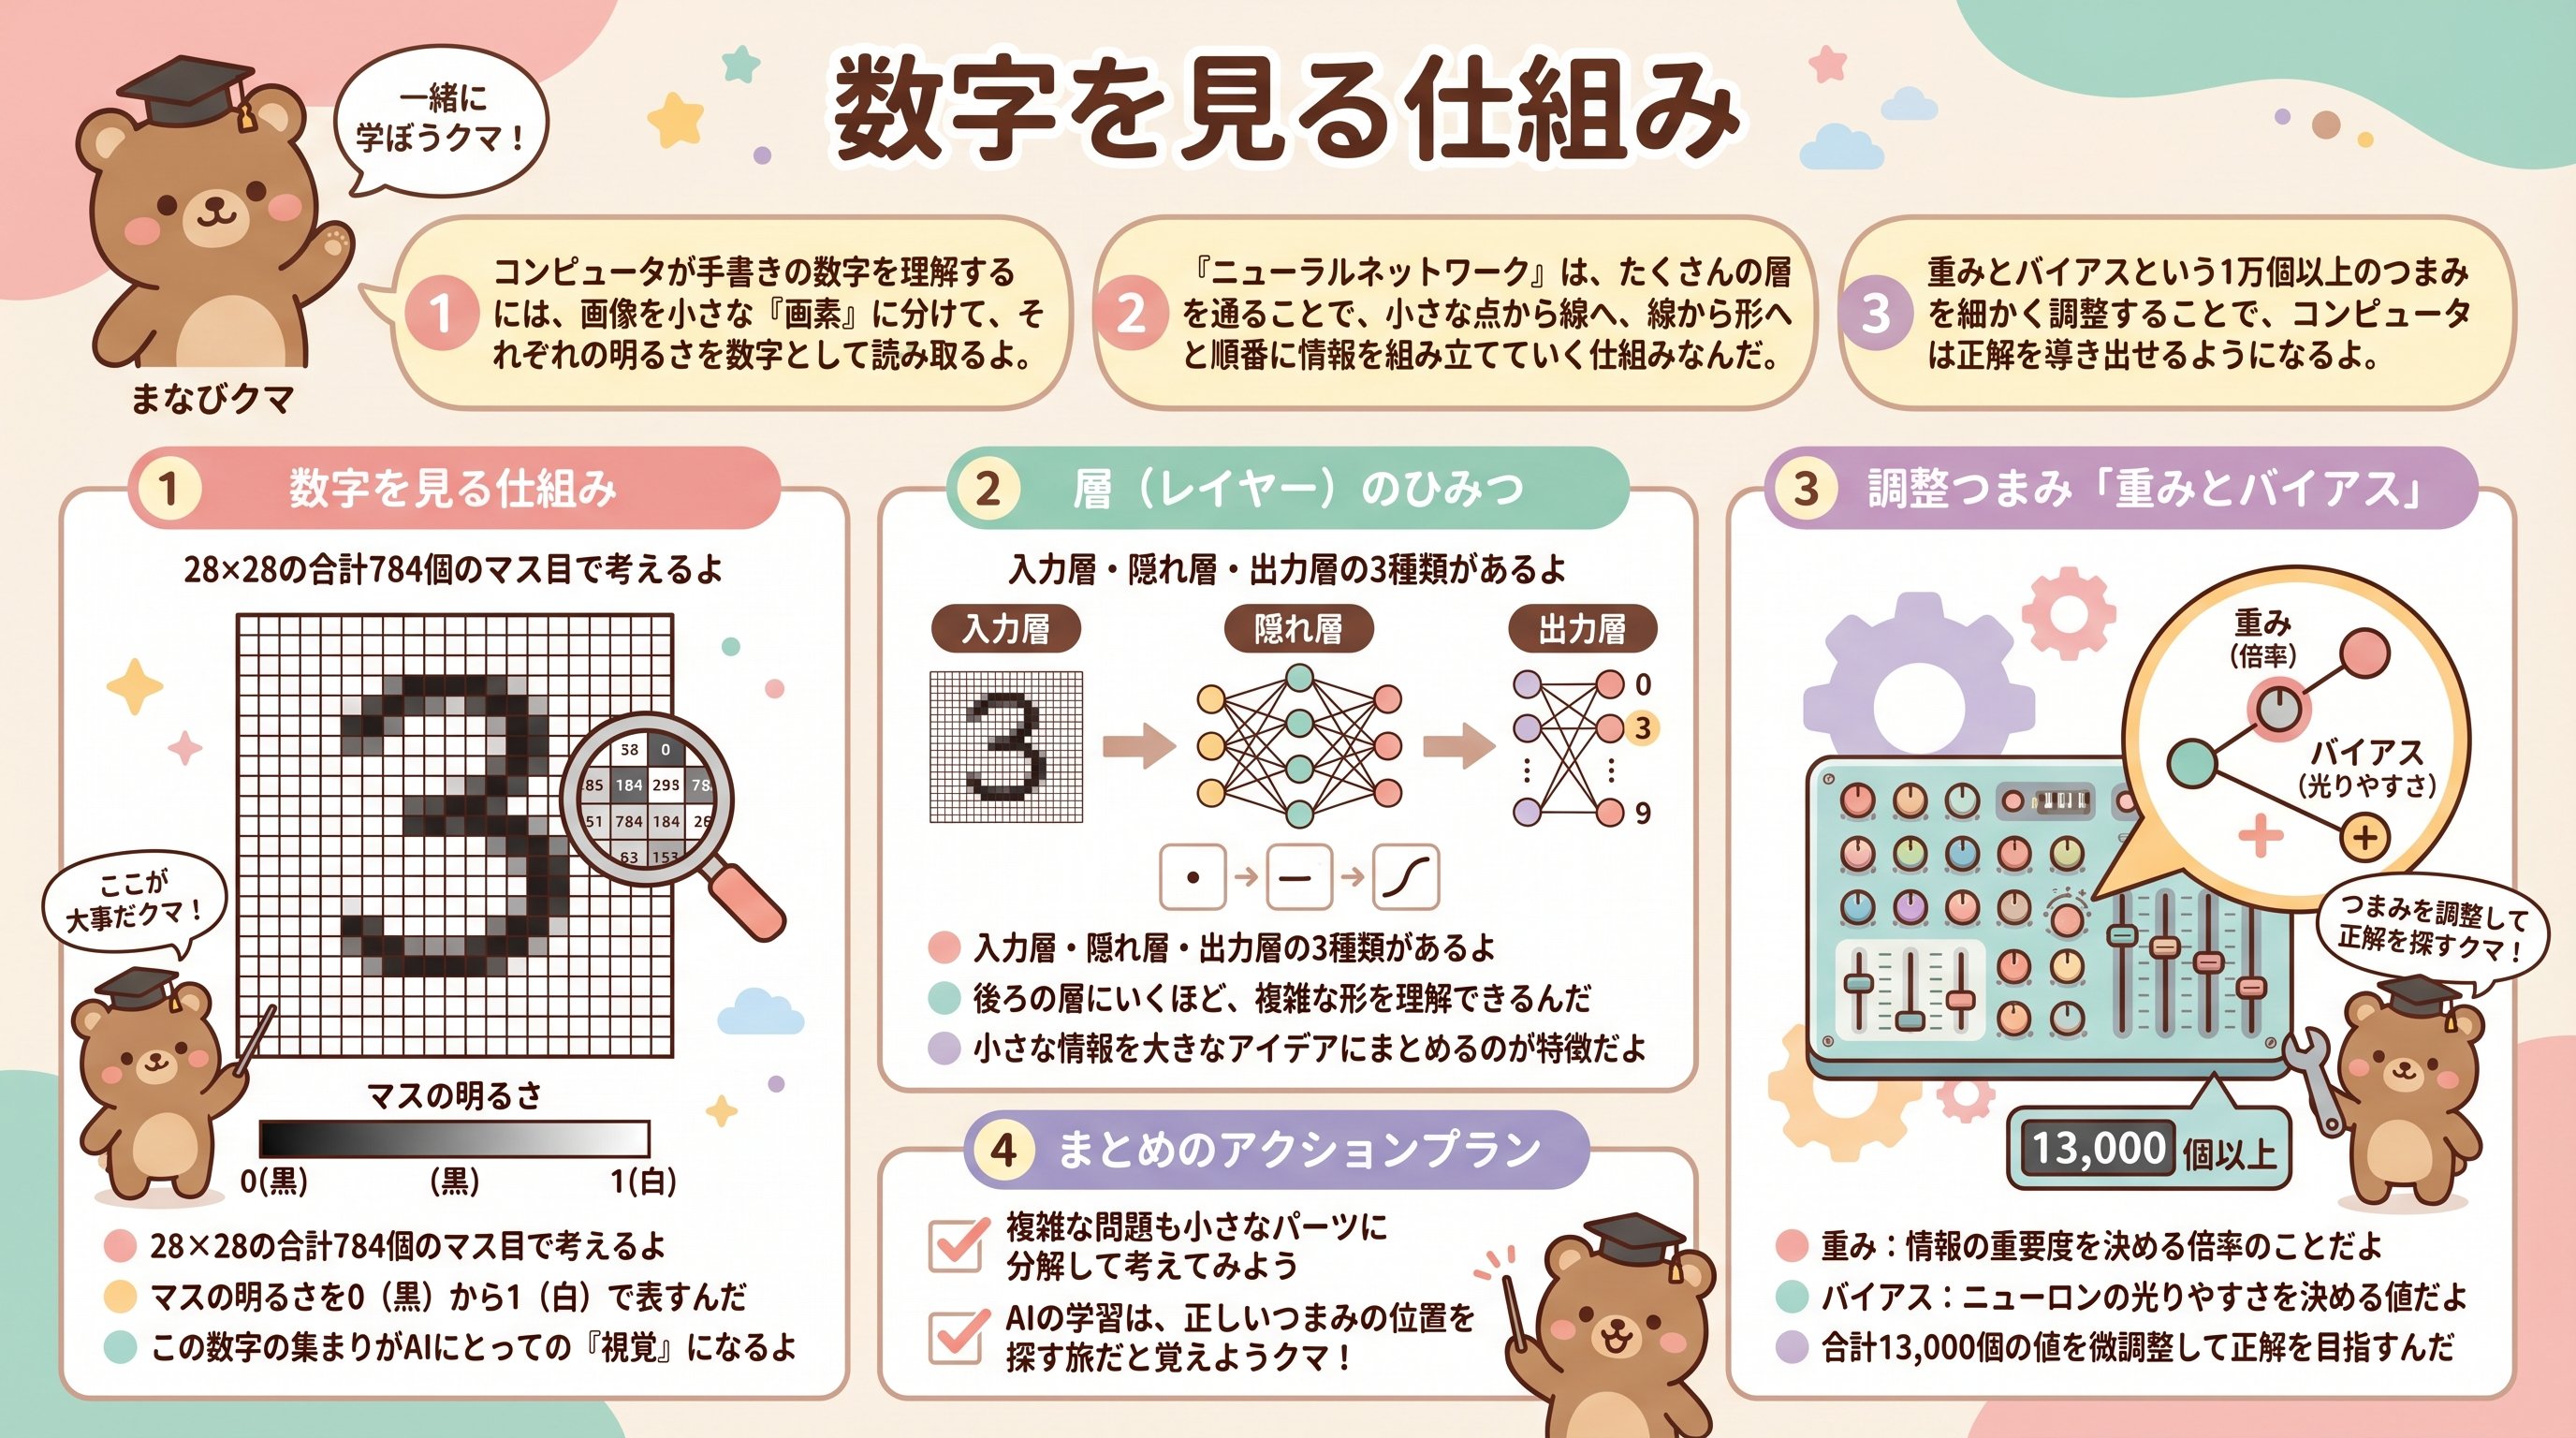
私たちは手書きの数字をパッと見て「これは3だ」とすぐに判断できるけれど、コンピュータにとってはただのピクセルの集まりに過ぎないんだよ。
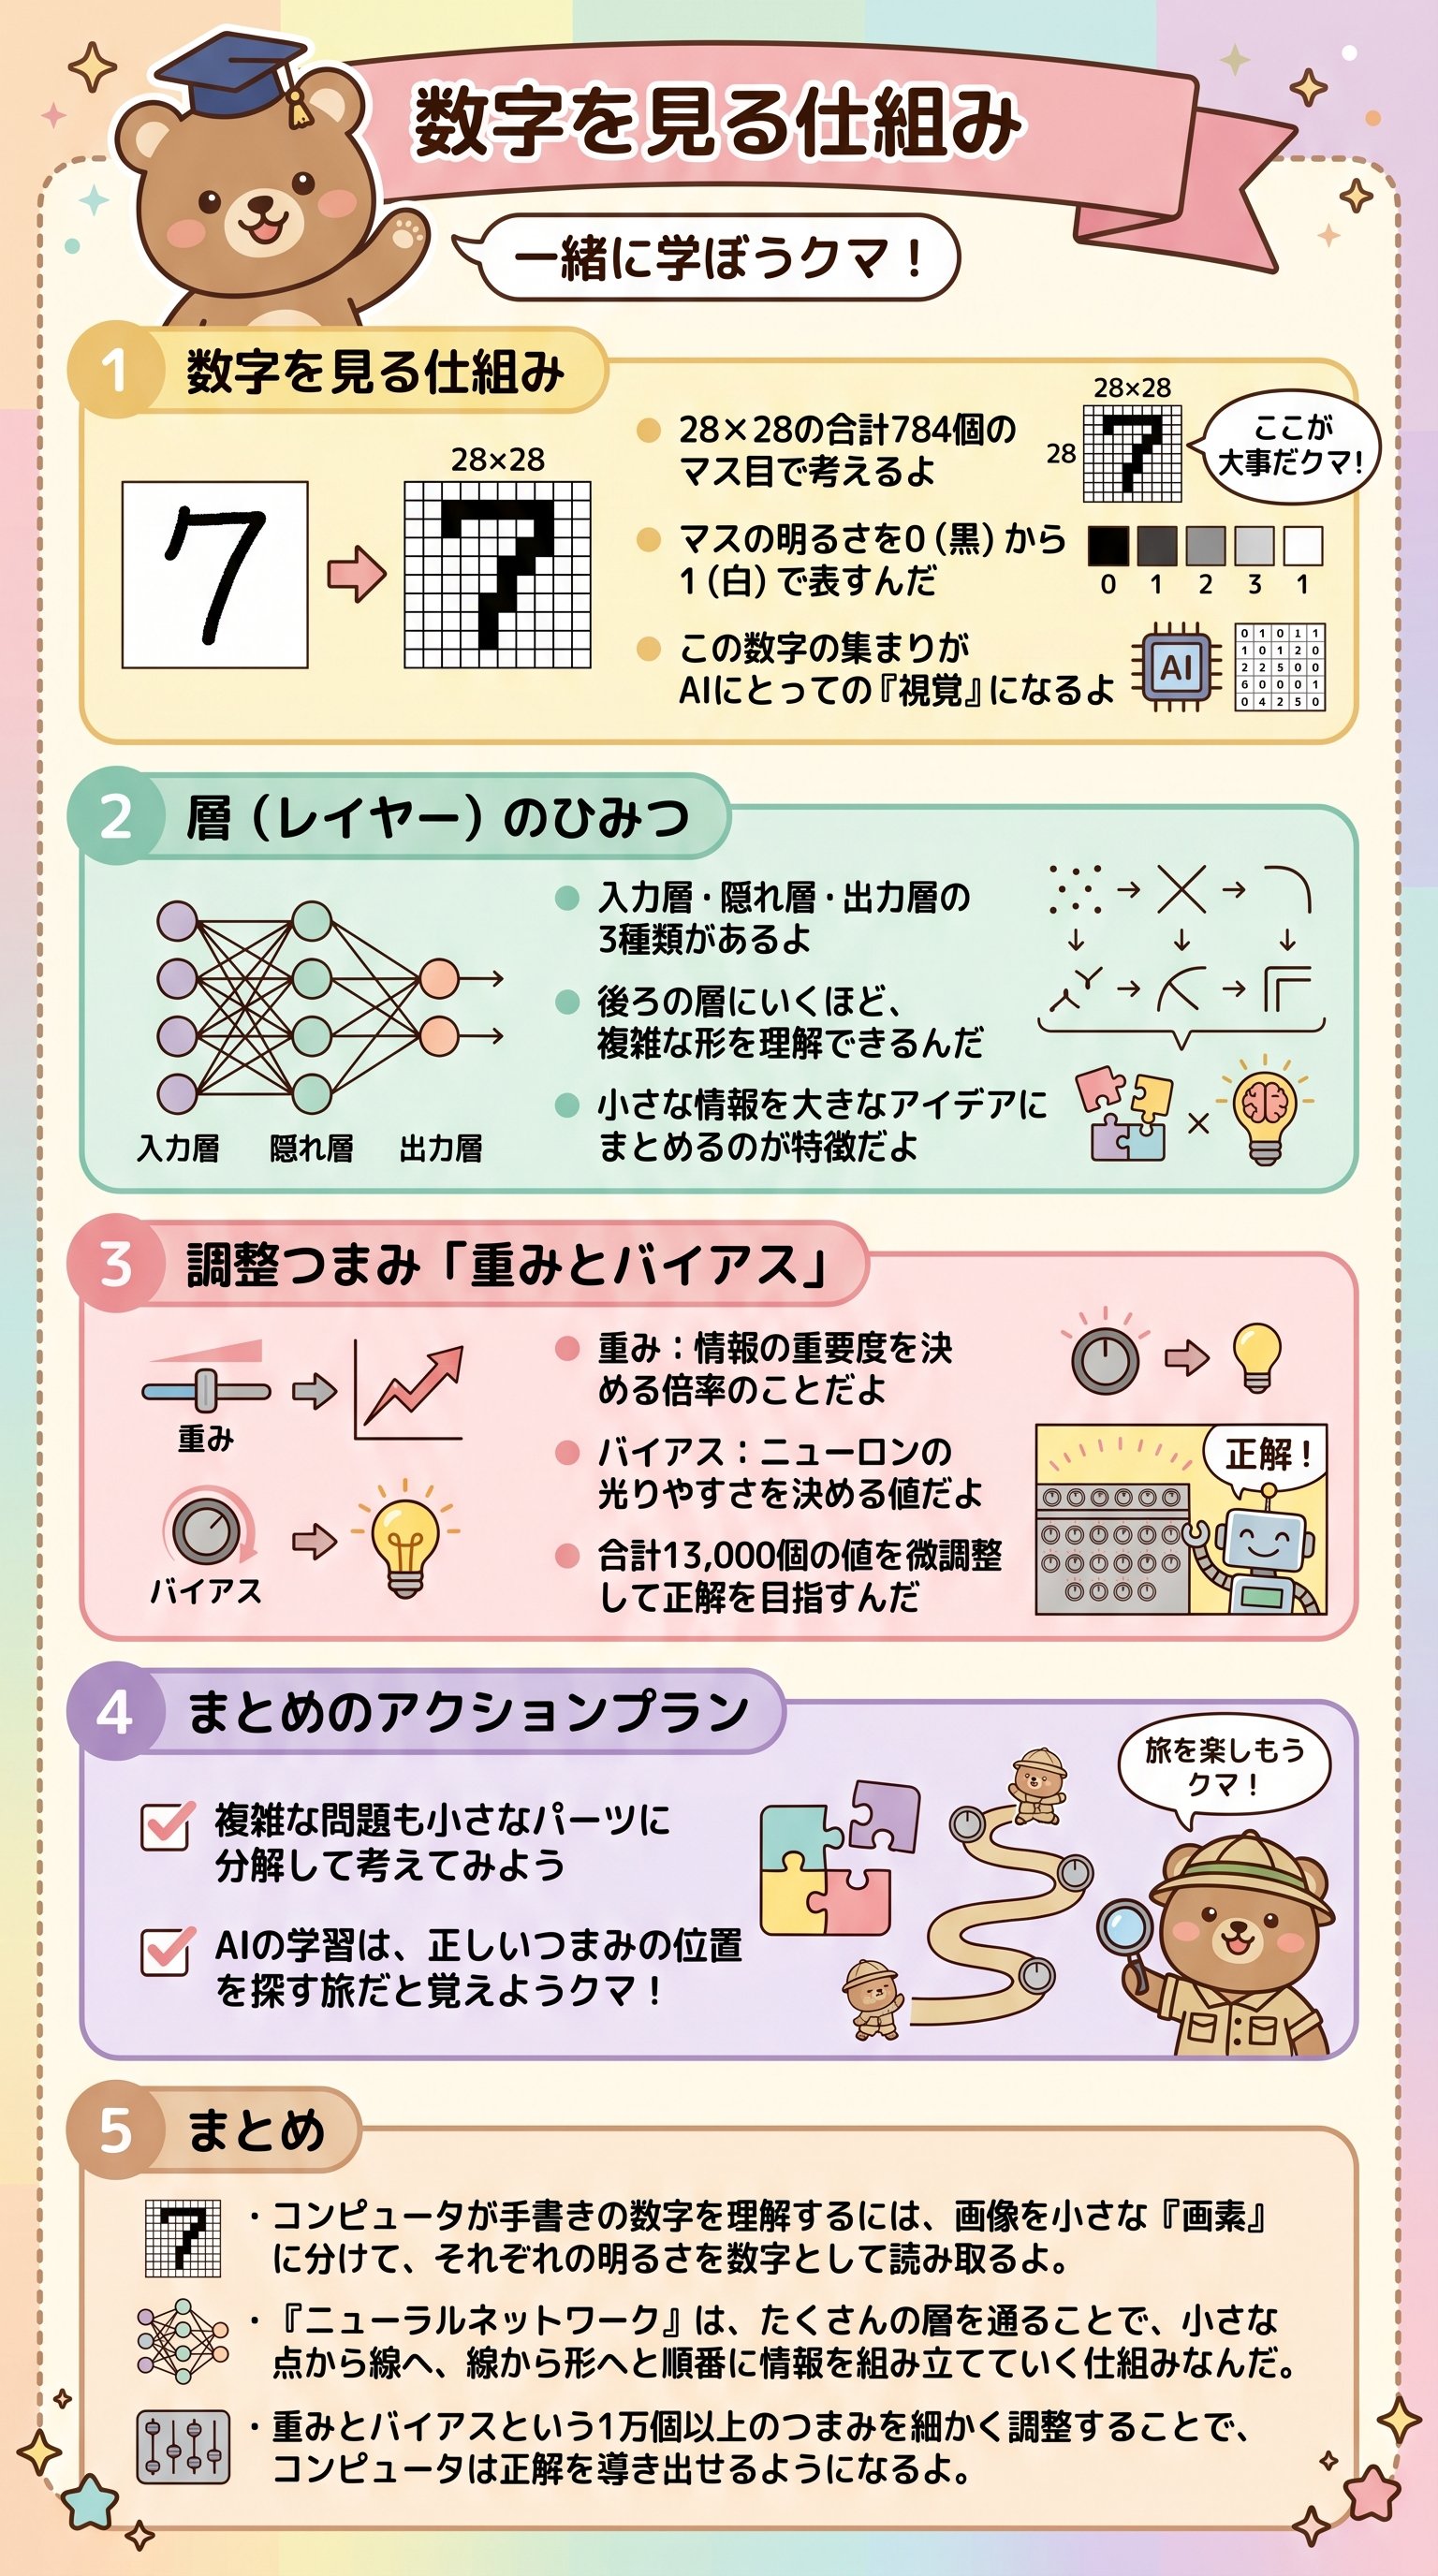
動画で使われているのは28ピクセル×28ピクセルの小さな画像で、全部で784個の点が集まって一つの数字を作っているんだね。
入力層の仕組み
この一つひとつのピクセルの明るさが、最初の層にあるニューロンの数値になるんだよ。
ピクセルが真っ黒なら「0」、真っ白なら「1」というように、明るさに応じて数値が決まる仕組みなんだ。
この数値のことを活性化と呼ぶんだよ。
活性化が高いほど、そのニューロンは「明るく輝いている」とイメージしてみてね。
この784個のニューロンが並んだものが、ネットワークの第一歩となる「入力層」になるんだ。
出力層への伝達
ニューラルネットワーク全体で見ると、この入力層から始まって、最後に「どの数字であるか」を判定する出力層まで、いくつもの層が重なっているんだ。
最後の層には、0から9までの数字に対応する10個のニューロンが用意されているんだよ。
画像を入力したときに、例えば「3」に対応するニューロンが一番明るく輝けば、ネットワークが「これは3だ」と判断したことになるんだね。
このように、目に見える画像がただの数字の羅列に変換され、それが次の層へと伝わっていくのが基本的な流れなんだ。
一見すると魔法のように見えるAIの判断も、実はこうした細かな数値のやり取りから始まっているんだよ。
初心者の人でも、まずは「ニューロン=数字が入った箱」だと考えておけば大丈夫だからね。
私たちが数字を見分けるとき、脳の中では無意識にたくさんの細胞が働いているけれど、コンピュータの中ではそれが数学的な計算に置き換わっているんだ。
この単純な「数字の箱」がどうやって複雑な形を理解していくのか、その秘密を探っていこう!
ニューロンは単なる数字を保持する入れ物であり、その数値が層を伝わることで判断が行われるんだね。
階層構造が小さな部品から形を作るプロセス
情報を分解する理由
ニューラルネットワークが層に分かれている理由は、複雑な問題を小さな部品に分解して理解するためなんだよ。
私たちが「9」という数字を見るとき、頭の中では「上に丸いループがあって、右側に縦の棒がある」というふうに、いくつかのパーツを組み合わせて考えているよね。
ネットワークの中間にある隠れ層も、これと同じような役割を果たそうとしているんだ。
特徴を見つけるステップ
最初の層がバラバラの点を見ているのに対して、次の層では短い線やエッジを見つけようとするんだね。
例えば、あるニューロンは「右上の小さな横線」に反応し、別のニューロンは「左下の縦線」に反応するように訓練されていくんだ。
そうして見つかった小さな線のパーツが次の層に伝ると、今度はそれらを組み合わせて「丸い形」や「長い直線」を認識できるようになるんだよ。
こうして情報を段階的に組み立てていく仕組みが、階層構造の素晴らしいところなんだ。
- 第1層個々のピクセルの明るさを読み取る
- 第2層短い線やエッジなどの小さな特徴を見つける
- 第3層円やループ、長い線などの部品を組み立てる
- 第4層部品の組み合わせから最終的な数字を特定する
抽象化のメリット
このように、抽象化の階段を一段ずつ登っていくことで、ネットワークは手書きの癖に左右されずに正解を導き出せるようになるんだね。
もし層が一つしかなかったら、バラバラの点からいきなり数字を当てるのはとても難しくなってしまうんだ。
小さなステップを積み重ねることで、大きな問題を解く力が生まれるんだよ。
この考え方は画像認識だけでなく、音声認識など他の分野でも同じなんだよ。
音の波形から音節を作り、単語を作り、最終的に文章の意味を理解するというように、どんな知的な作業も「部品の組み立て」として捉えることができるんだ。
現代のAIが賢いのは、この抽象化のレイヤーを上手に使いこなしているからなんだね。
私たちの脳が当たり前に行っている「見る」という行為を、コンピュータに教えるために考え出されたこの構造は、非常に合理的で美しいものなんだ。
次の章では、この層の間で具体的にどんな計算が行われているのか、もっと詳しく見ていこうね。
重みとバイアスが情報の流れを調整する役割
重みによる重要度の調整
ネットワークの中にあるニューロン同士のつながりには、情報の重要度を決める「重み」という設定があるんだ。
あるニューロンが次の層のニューロンを光らせるかどうかを決める際、すべての情報を平等に扱うわけではないんだよ。
例えば「中央にあるピクセルは形を決めるのに重要だけど、端っこのピクセルはあまり関係ない」という場合、中央のピクセルからのつながりには大きな重みを設定するんだ。
逆に、関係ない場所には「0」に近い重みや、ときにはマイナスの重みをつけることもあるんだね。
加重和とバイアス
具体的には、前の層のすべての活性化に重みをかけ算して、それらを全部足し合わせる計算をしているんだ。
これを加重和と呼ぶよ。
もし特定のパターン(例えば円の形)に重みを集中させておけば、そのパターンが現れたときだけ、計算結果が大きなプラスの数字になるという仕掛けなんだ。
重みは、まさに情報のフィルターのような役割をしているんだね。
| 要素 | 役割の例え | 数学的な意味 |
|---|---|---|
| 重み (weights) | 情報の重要度を測るフィルター | かけ算される係数 |
| バイアス (bias) | 反応のしやすさを決めるハードル | 加算される数値 |
| 活性化関数 | 数値を0と1の間に収める調整役 | シグモイド関数など |
加重和を計算したあとに登場するのがバイアスなんだ。
これは、そのニューロンが「どれくらい簡単に光るか」を決める数値だよ。
学習と活性化関数
例えば、加重和が10を超えたときだけ反応してほしいなら、バイアスに「-10」を設定しておくんだ。
そうすれば、合計が11になったときだけ、結果がプラスになってニューロンが点灯するようになるんだね。
動画で紹介されているシンプルなネットワークでも、重みとバイアスの数は全部で13,000個もあるんだ。
この膨大な数の「つまみ」を絶妙に調整することで、コンピュータは複雑な文字を識別できるようになるんだね。
私たちが「学習」と呼んでいるのは、まさにこの13,000個の数字をコンピュータが自動で見つけ出す作業のことなんだよ。
計算結果はそのままでは非常に大きな数字になってしまうこともあるから、最後に「シグモイド関数 (sigmoid function)」というものを使って、数値を無理やり0から1の間に押しつぶすんだ。
これによって、どんな入力が来ても次のニューロンに伝わるのは「0から1の間の活性化」という一貫したルールが守られるようになるんだよ。
数学的な処理を繰り返すことで知能が生まれる過程は、本当に興味深いよね。
一つひとつの計算は単純なかけ算と足し算の繰り返しだけど、それが1万回以上組み合わさることで、まるで意志を持っているかのような判断が可能になるんだ。
この仕組みを知ると、AIが少し身近に感じられるかもしれないね。
次は、この膨大な計算を賢くこなすための数学的な表現について学んでいこう。
行列計算による膨大な数値処理の効率化
行列とベクトルの活用
1万個以上の計算を一つずつ手で書くのは大変だから、数学では「行列」という便利な道具を使って一気に処理するんだよ。
ニューロンの活性化を縦に並べたものをベクトルと呼び、重みのつながりを表にまとめたものを行列と呼ぶんだ。
これらを掛け合わせる「行列ベクトル積」という計算を使うと、ある層から次の層への情報の伝達を一文の数式で表現できてしまうんだね。
これは単に見た目がスッキリするだけでなく、コンピュータが計算するスピードを劇的に速くしてくれるんだよ。
計算の効率化
コンピュータの中にあるライブラリは、こうした行列の計算を高速に行うのがとても得意なんだ。
一つひとつのニューロンの計算をバラバラに行うよりも、大きな塊として一気に処理したほうが効率がいいんだね。
この線形代数という数学の力が、現代のディープラーニング (deep learning) の驚異的なスピードを支えている重要な土台になっているんだよ。
- 1ベクトル化層にある全ニューロンを一つの列にまとめる
- 2行列化すべての重みを一つの大きな表にまとめる
- 3行列演算行列とベクトルを掛け合わせて次の層の値を出す
- 4バイアス加算各ニューロンに決まった数値を足す
- 5一括変換活性化関数を適用して0から1に収める
巨大な関数としてのネットワーク
こうして見ると、ネットワーク全体は実は巨大な関数そのものなんだ。
784個の数字を入力すると、13,000個のパラメータを使って計算し、最後に10個の数字を出力する一つの大きな計算式だといえるんだね。
この関数がどんな入力を受け取っても正しく反応するように、重みとバイアスを微調整していくのが学習の本質なんだよ。
この表記法のおかげで、エンジニアの人たちは複雑なネットワークをプログラミングコードで簡単に書くことができるんだ。
数千、数万という層を持つ巨大なAIであっても、基本的な数学のルールは驚くほどシンプルに保たれているんだよ。
私たちが普段使っている翻訳アプリや画像認識サービスも、裏側ではこうした行列が猛スピードで回転しているんだね。
数学は、一見すると冷たい数字の集まりに見えるかもしれないけれど、ニューラルネットワークの世界では命を吹き込むための魔法の呪文のようなものなんだ。
この美しい数学的なまとまりがあるからこそ、私たちは複雑な世界を計算可能なものとして扱えるようになっているんだクマ。
現代のAIを支える活性化関数の進化
シグモイド関数からReLUへ
動画の最後では、昔主流だった方法と、今のAIが使っている方法の違いについても触れられているんだよ。
昔のネットワークでは、数値を0と1の間に収めるためにシグモイド関数がよく使われていたんだ。
これは生物の神経細胞が「発火するか、しないか」という状態に近いから採用された背景があるんだね。
でも、最近の非常に深いネットワークでは、シグモイド関数を使うと学習がうまく進まないという問題が見つかってきたんだよ。
ReLUの仕組み
そこで現代の主流になっているのが、ReLU (Rectified Linear Unit)という関数なんだ。
これは日本語で「整流線形ユニット」と呼ばれることもあるよ。
ReLUの仕組みはシグモイドよりもさらに単純で、「0以下の数字はすべて0にして、0より大きい数字はそのまま通す」というものなんだ。
このシンプルさが、計算をより速くし、学習をスムーズに進める鍵になったんだね。
- シグモイド関数なだらかなカーブで0から1に収める(古い学校)
- ReLUマイナスを切り捨て、プラスをそのまま使う(現代のスタンダード)
- 目的の変化生物の模倣よりも、効率的な学習を優先するようになった
進化し続けるAI技術
なぜReLUのほうがいいのかというと、深いネットワークで多くの層を通り抜けるときに、勾配が消えてしまうのを防げるからなんだ。
シグモイドだと端っこのほうで変化が少なくなってしまうけれど、ReLUはプラスの範囲なら変化がそのまま伝わるから、コンピュータが「どこを直せばいいか」を理解しやすくなるんだね。
技術の進歩は常によりシンプルな解決策へと向かっているんだよ。
こうした関数の選択一つとっても、AIの歴史の中でたくさんの試行錯誤があったことがわかるよね。
動画の中でゲストの Lisha Li (リー・リー) 博士が話していたように、かつてはシグモイドが常識だったけれど、今はReLUのほうが訓練しやすいことが分かってきているんだ。
私たちが学んでいることは、今この瞬間も進化し続けている生きた知恵なんだよ。
ニューラルネットワークの構造を理解できたなら、次は「どうやってこのネットワークが自分で間違いを直して賢くなっていくのか」という学習のステップに進む準備が整ったことになるね。
複雑そうに見える山も、一歩ずつ登っていけば必ず頂上が見えてくるから、これからも一緒に楽しく学んでいこうクマ!
ネットワークの構造がわかると、世の中のニュースや技術ももっと身近に感じられるようになるはずだよ。
この記事が、君の学びの新しい扉を開くきっかけになったらとっても嬉しいな。
これからも自分を信じて、一歩ずつ進んでみてね。
活性化関数の進化によって、今のAIはより効率的に学習できるようになったんだね。
