AI生成テキストを「見破る」ための新たな解決策
現在、世界中で爆発的に普及しているChatGPT等の大規模言語モデル(Large Language Models)は、その利便性の裏で「AIによる代筆」や「フェイク情報の拡散」という深刻な課題を突きつけている。
これまでの検知手法は、別のニューラルネットワークを用いてAIらしさを判定するものが主流だった。
しかし、マイク・パウンド(Mike Pound)博士によれば、この手法は極めて非効率であり、モデルが更新されるたびに再学習が必要になるという致命的な欠陥がある。
そこで今、メリーランド大学(Maryland)のジョン・キルヒェンバウアー(John Kirchenbauer)氏らが提唱した「電子透かし」という全く新しいアプローチが注目を集めている。
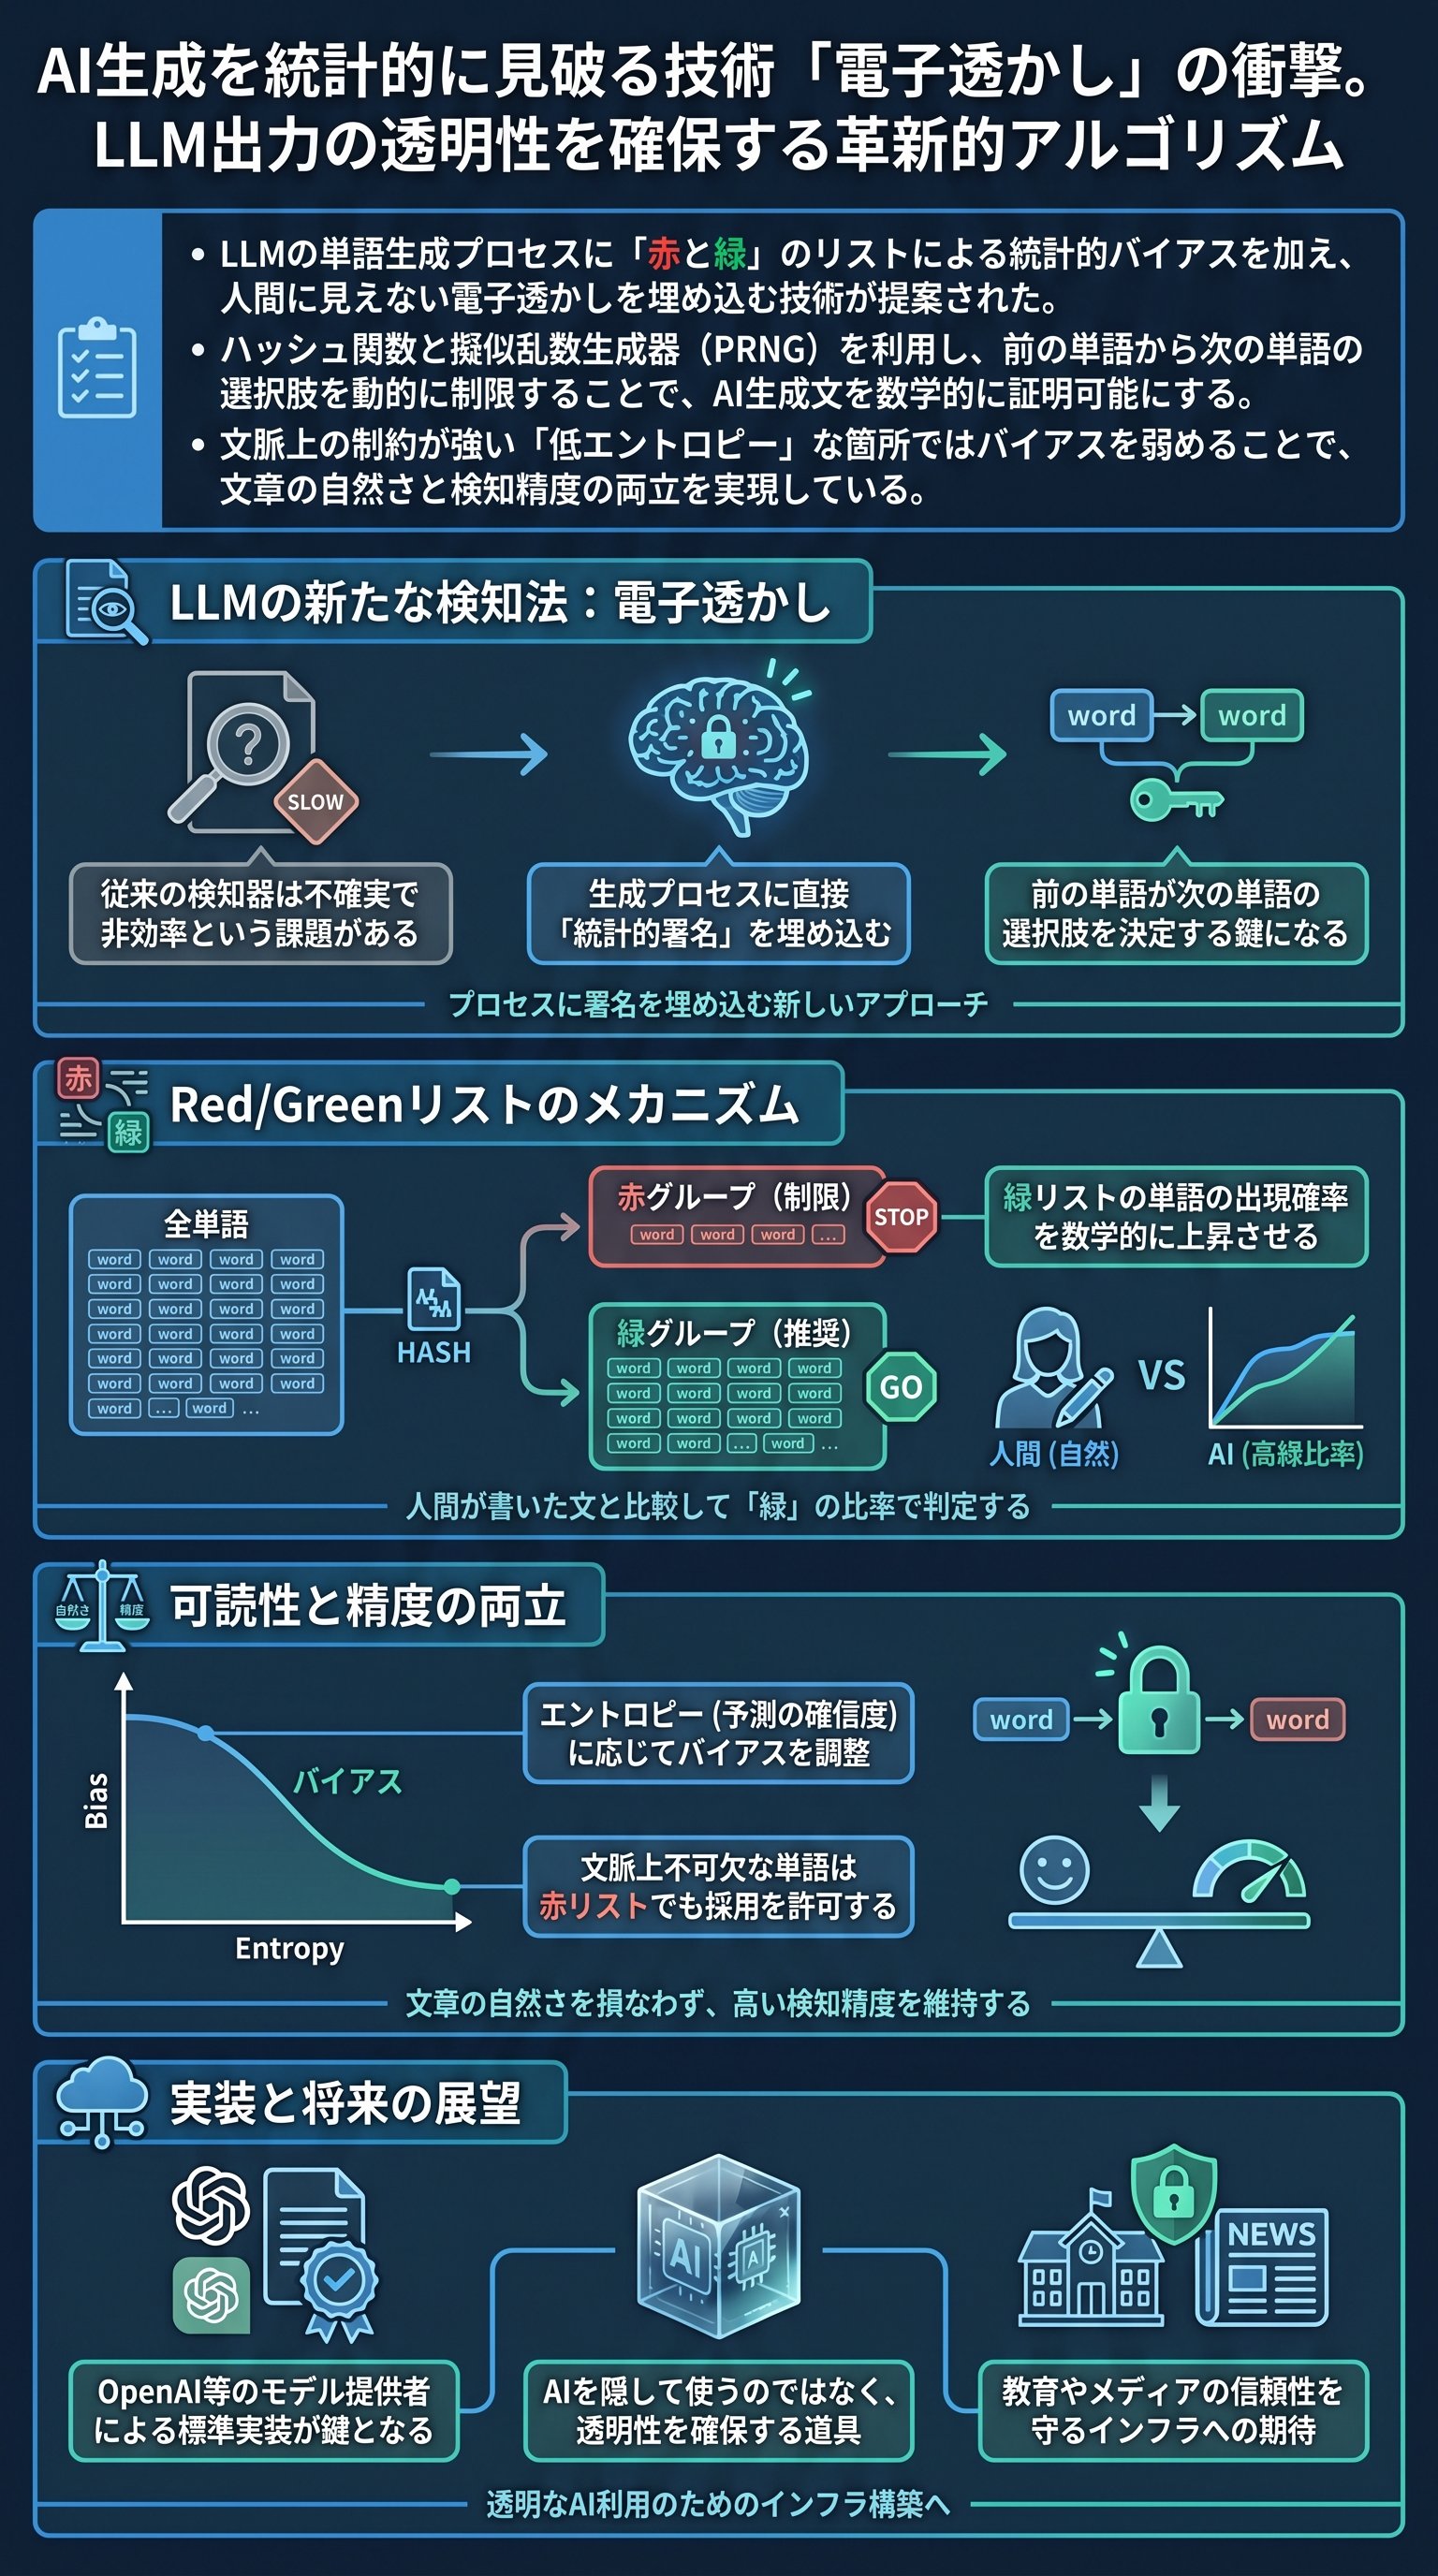
この技術の核心は、AIが文章を生成するその瞬間に、統計的な「署名」を埋め込むことにある。
具体的には、テキスト生成のアルゴリズムに直接介入し、特定の単語が選ばれる確率を意図的に操作するのだ。
これにより、後からその文章を分析した際に、統計的に「偶然では起こり得ない偏り」を検出することで、AI生成物であることを確実に特定できるようになる。
この手法は、文章の質を維持しながら透明性を確保する。
今この瞬間、AIと人間の境界線を定義し直す技術が必要とされているのだ。
教育現場での不正防止や、ニュース記事の信頼性担保において、この技術はゲームチェンジャーとなる可能性を秘めている。
電子透かしの核となる「Red/Greenリスト」の仕組み
電子透かしの具体的なアルゴリズムは、非常に数学的で洗練されている。
LLMが次の単語(トークン)を予測する際、各単語の出現確率を示す「ロジット」というスコアを算出する。
通常はこのスコアに基づいてランダムに単語を選ぶが、電子透かしを導入する場合、まず前の単語をハッシュ関数にかけ、擬似乱数のシード値を生成する。
このシード値を用いて、全語彙をランダムに「緑リスト(Green List)」と「赤リスト(Red List)」の2つのグループに分割するのだ。
- 緑リスト生成を推奨する単語群。確率スコアにボーナスが加算される。
- 赤リスト生成を制限する単語群。確率スコアが据え置かれるか、減算される。
このプロセスを単語ごとに繰り返す。
例えば、「The」という単語の次に来る語彙が分割され、緑リストに入った単語が選ばれやすくなる。
次にその選ばれた単語を元に、また新しい赤と緑のリストが作られるという仕組みだ。
この結果、生成された文章には不自然なほど多くの緑リストの単語が含まれることになる。
人間が普通に文章を書いた場合、各単語が緑リストに入る確率は常に50%であるため、文章全体で緑の単語が極端に多い場合、それはAIが生成したという動かぬ証拠となる。
| 比較項目 | 従来のニューラルネットワーク検知 | AI電子透かし(メリーランド大学方式) |
|---|---|---|
| 計算コスト | 非常に高い(別のLLMが必要) | 極めて低い(ハッシュ計算のみ) |
| 確実性 | 推測に基づき、不透明 | 統計的に数学的証明が可能 |
| 耐性 | 新モデル登場で精度低下 | 理論上、モデルを選ばず適用可能 |
| 実装の容易さ | 学習データが膨大に必要 | 生成側へのアルゴリズム組み込みで完結 |
読者に違和感を与えない「統計的バイアス」の技術
「単語の選択を制限したら、文章が支離滅裂になるのではないか?」という懸念は当然だ。
しかし、この研究の優れた点は、エントロピー(予測の不確実性)を考慮している点にある。
例えば、「バラク(Barack)」という単語の次にくるのは、ほぼ確実に「オバマ(Obama)」である。
このような低エントロピーな状況で「Obama」が赤リストに入ったからといって無理に別の単語を選ばせれば、文章は崩壊してしまう。
そのため、このシステムは「絶対に赤を使わない」のではなく、「選択に余裕がある時(高エントロピー時)にだけ緑を優先する」というソフトな制約を採用している。
次の単語の候補が複数ある場合にのみ、緑リストの単語にわずかなバイアスをかけるのだ。
これにより、読者は違和感を全く抱くことなく、自然な文章として読み進めることができる。
- 1前のトークンのハッシュ値からシードを生成
- 2語彙をRed/Greenに分割
- 3緑の単語のロジット値に定数を加算
- 4ソフトマックス関数で確率分布を再計算し、単語を選択
統計的な微差を積み重ねることで、巨大な真実を浮き彫りにする。
これこそがこのアルゴリズムの美しさだ。
テキストの可読性を一切犠牲にせず、数学的なメタデータを文章そのものに刻み込んでいるのである。
未来のAI活用と「透かし」が果たす役割
この技術を実用化するためには、オープンエーアイ(OpenAI)やグーグルといった大規模モデルの提供者が、システムにこのアルゴリズムを標準実装する必要がある。
もし業界標準としてこの「電子透かし」が組み込まれれば、学生が提出したレポートや、インターネット上の記事がAIによって自動生成されたものかどうかを、誰でも瞬時に検証できるツールが提供されるだろう。
もちろん、このシステムに対する「攻撃」も想定されている。
例えば、単語の間に絵文字を挿入してハッシュ計算を狂わせたり、AIの出力を人間が大幅に書き換えたりする方法だ。
しかし、ノッティンガム大学(Nottingham)のマイク博士は、十分な長さの文章があれば、多少の改ざんがあっても統計的な痕跡を完全に消し去ることは困難であると指摘している。
長期的には、AIとの付き合い方は「検知」から「共生」へとシフトしていくだろう。
しかし、その過渡期において、この電子透かし技術は社会の信頼を維持するための最強の盾となるに違いない。
