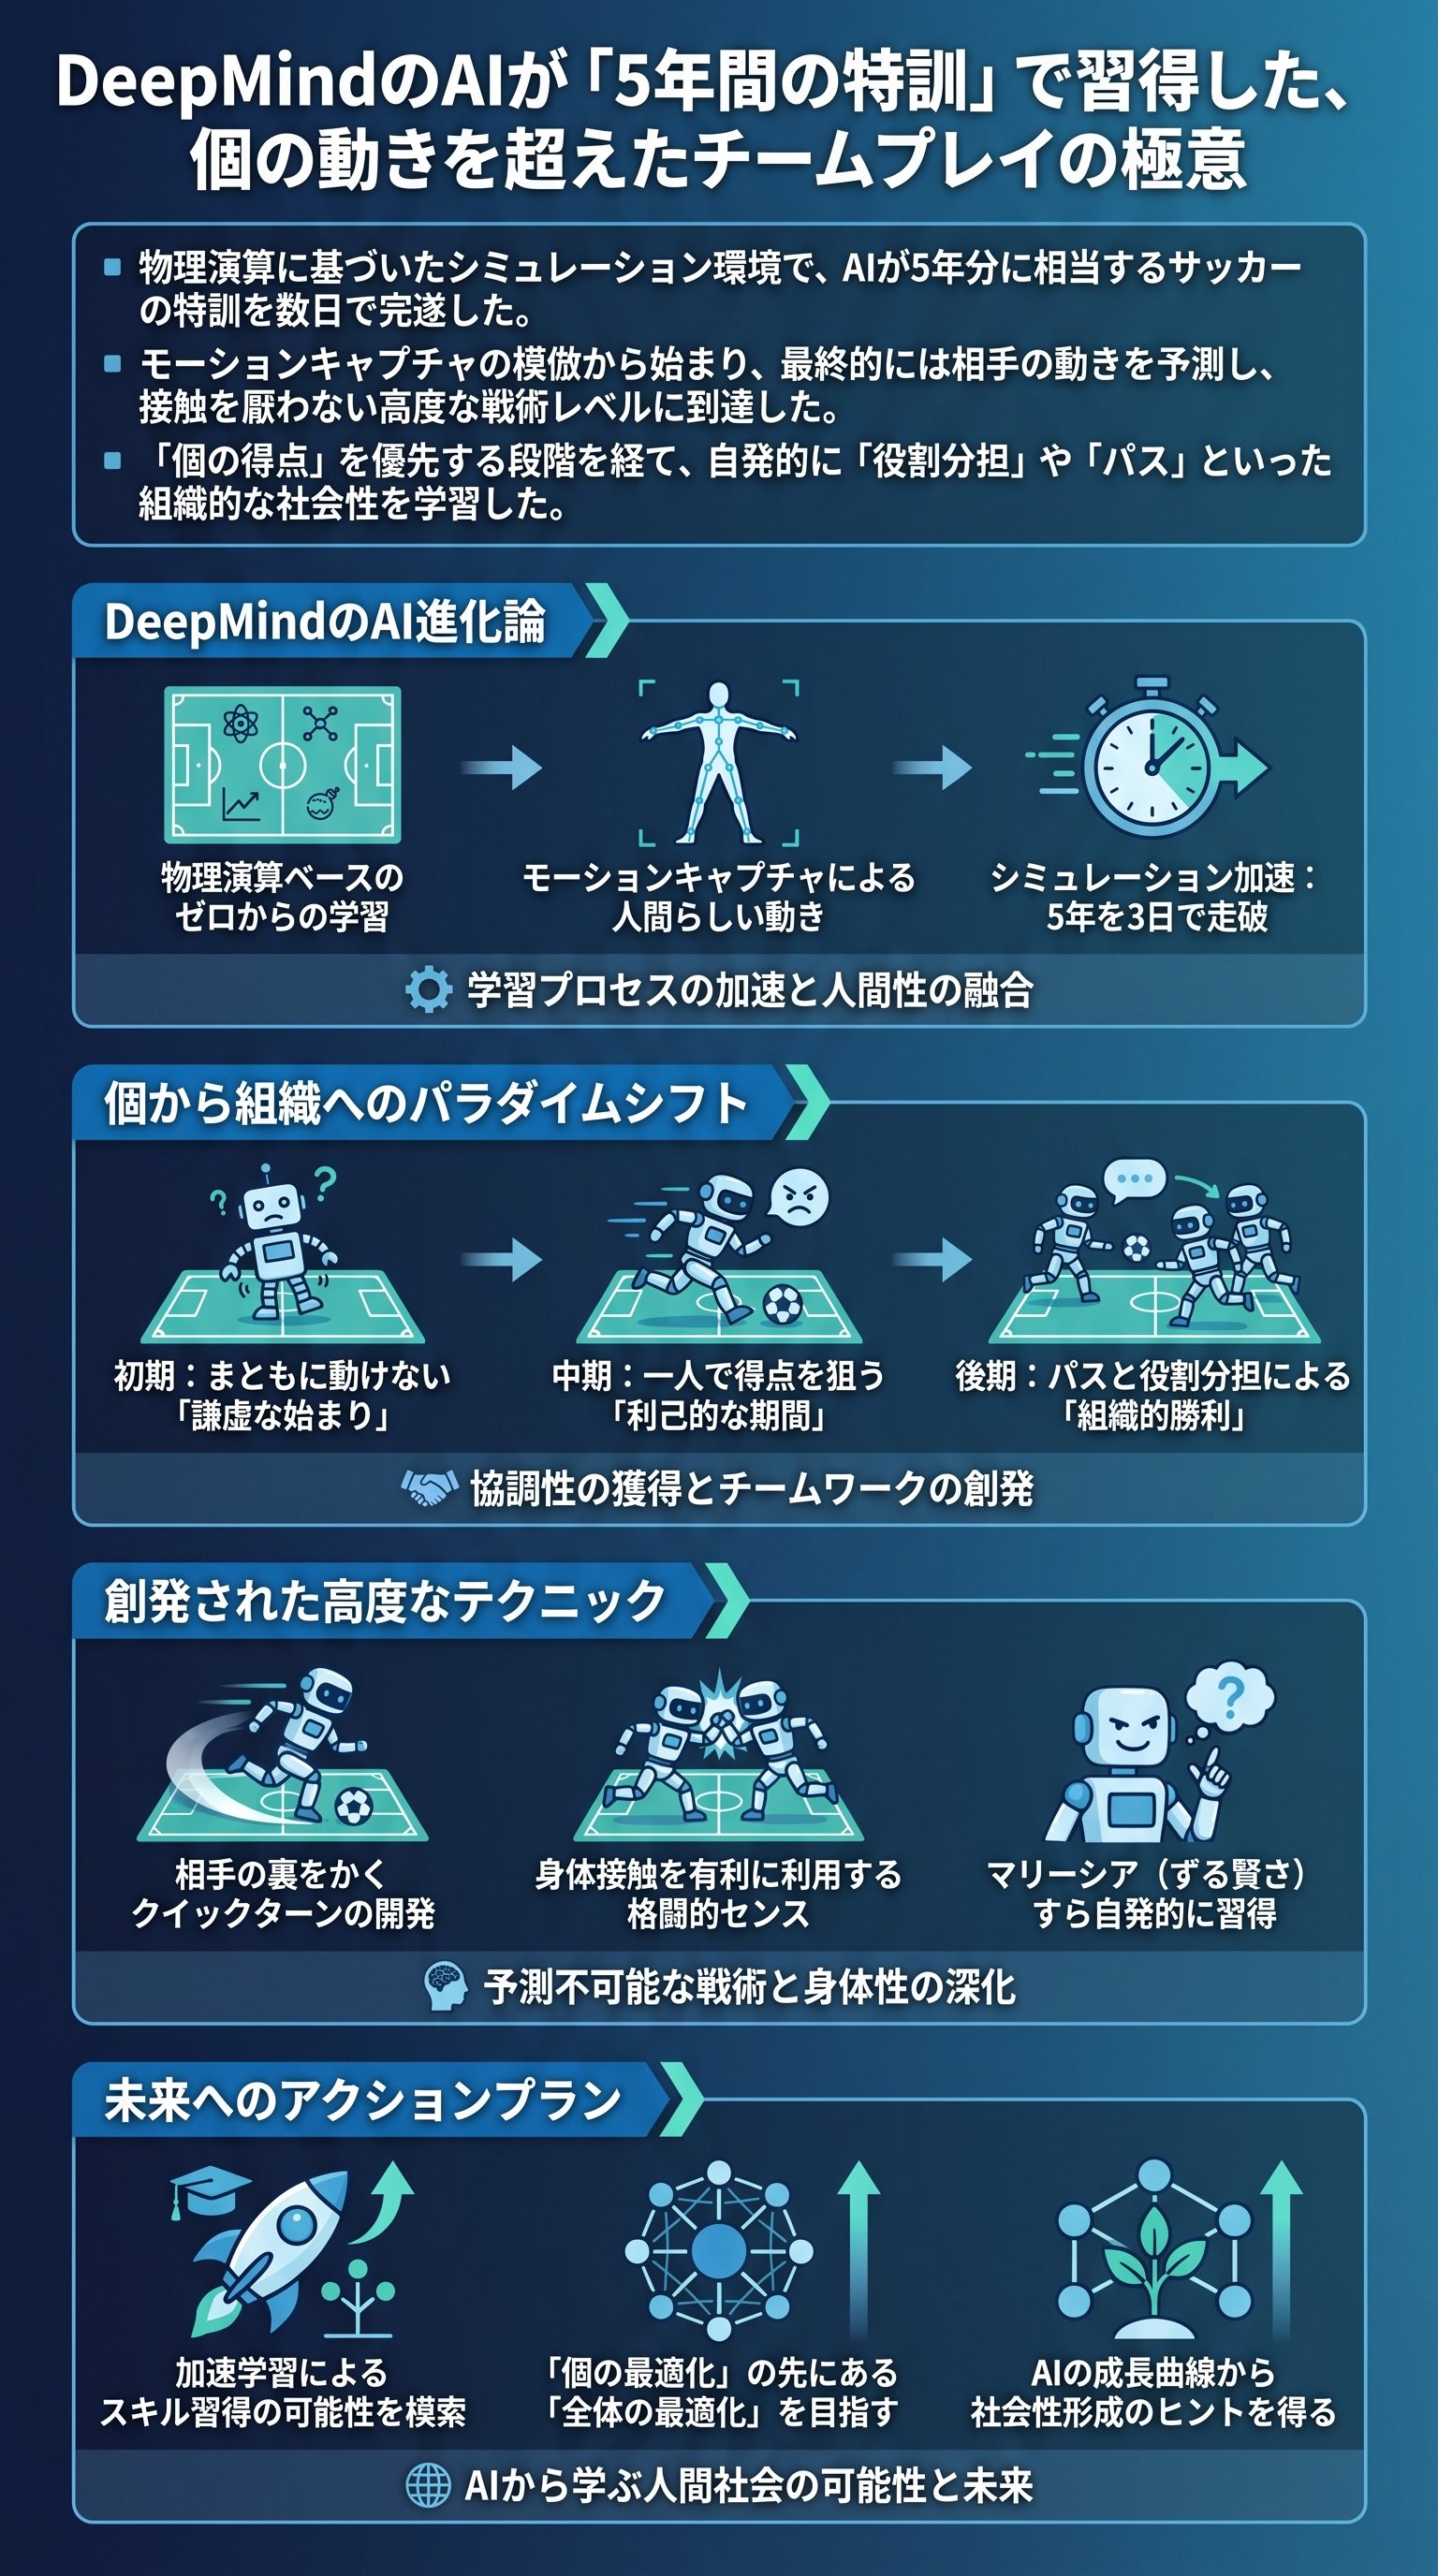
物理演算が紡ぐ「ゼロからの歩行」
ディープマインドが発表した最新の研究は、AIが仮想空間でいかにして複雑な身体操作を習得するかという限界に挑んだものです。
物語は、物理法則が支配するゲームエンジン内から始まります。
当初、AIエージェントたちは自らの関節にどの程度のトルク(回転力)をかけるべきかすら分からず、まともに立つこともできませんでした。
これは、私たちが当たり前に行っている「歩く」「蹴る」という動作がいかに高度な計算に基づいているかを物語っています。
学習の初期段階で導入されたのが、人間のモーションキャプチャ(Motion Capture)データです。
AIはまず、実在する人間の動きを徹底的に「模倣」することから始めました。
これにより、ぎこちない機械的な動きから、人間らしいスムーズな歩行や走行へとステップアップしていったのです。
しかし、これだけではボールをコントロールすることはできません。
単なる模倣を超えた「意志」を持つ動きが必要だったのです。
- 重力、摩擦、トルクの複雑な計算
- モーションキャプチャによる人間動作のトレース
- 基本的な直進と方向転換の習得
時空の歪みを味方につけるDeepMindの訓練手法
この研究で最も驚くべき点は、その訓練期間の圧倒的な圧縮にあります。
現実世界では1秒は1秒としてしか進みませんが、高性能なコンピューターを用いたシミュレーション空間では、時間の概念を操作できます。
DeepMindのエンジニアは、AIに計「5年間」に及ぶ猛特訓を課しましたが、現実世界での経過時間はわずか3日でした。
この時間短縮(タイムディレーション)こそが、AI進化のブースターとなります。
- 1コンピュータ上のシミュレーション環境を構築
- 2物理演算の処理速度を極限まで引き上げる
- 3現実の数ミリ秒でゲーム内の1秒を計算
- 424時間体制で5年分の試行錯誤を反復
さらに訓練期間を50日に延ばすと、AIはもはや「サッカー選手」の動きを完全に凌駕し始めました。
単にボールを追いかけるのではなく、数手先の展開を予測し、自らのポジショニングを最適化する能力を身につけたのです。
これにはDr. Károly Zsolnai-Fehér(カーロイ・ゾルナイ・フェヘール)も、「椅子から転げ落ちるほど驚いた」と語っています。
進化するAIが到達した「予測」と「駆け引き」
50日(シミュレーション上ではさらに長期間)の訓練を経たAIたちは、高度な戦術的知性を発揮し始めました。
特筆すべきは、相手ディフェンダーの裏をかくための「クイックターン」や、意表を突く「ハイキック」です。
これらはプログラムによって教え込まれたものではなく、勝利という報酬を最大化するために、AIが自発的に「発見」したテクニックです。
今この瞬間、AIは単なるプログラムから『アスリート』へと進化したのだ
| 特徴 | 初期段階(5日) | 後期段階(50日) |
|---|---|---|
| 動作 | 基本的な走行とドリブル | 予測、フェイント、接触プレイ |
| チームワーク | ほぼ個人のみで完結 | パス、役割分担、スペース活用 |
| 障害対応 | 転ぶと復帰に時間がかかる | 転倒を戦略に組み込む柔軟性 |
特筆すべきは、怪我を装う(かのように見える)振る舞いです。
接触後に倒れ込み、あたかも動けないふりをしておきながら、守備が必要な瞬間に劇的な「奇跡の復活」を遂げる様子は、現代のプロサッカー選手が時折見せるマリーシア(ずる賢さ)を彷彿とさせます。
物理的な衝突をいかに有利に利用するか、AIは勝負の非情さも学習したのです。
自己利益を超えた「役割分担」というブレイクスルー
この研究で最も感動的なデータは、役割分担(Division of Labor)の発生を示すグラフです。
興味深いことに、学習の途中でAIたちは一時的に「非常に利己的」になる期間がありました。
一人でゴールを決められるスキルを身につけた直後、彼らはパスを出すことをやめ、独りよがりなプレイに走ったのです。
しかし、さらに学習を進めると、組織として動いた方が得点効率が高いことに気づきました。
- パス頻度の劇的な上昇
- 攻撃と守備の明確な分離
- チームメイトの動きに合わせたカバーリング
最終的に、AIたちのイロレーティング(Elo Rating)は右肩上がりの成長を見せました。
これは、対戦を繰り返す中でスキルが確実に向上している客観的な証拠です。
最初は単なる「青い曲線」に一喜一憂していた研究者たちも、その曲線が示す「知性の創発」に深い感動を覚えました。
現代の学習アルゴリズムは、ついに生物が数百万年かけて進化させた「社会性」の入り口に立っているのです。
