AI開発の競争力を左右する法改正の背景
AI開発を阻む「同意」の壁
政府が閣議決定した個人情報保護法の改正案は、日本のデジタル競争力を根底から立て直すための極めて重要なステップです。
現在の法律では、病歴や犯罪歴といった「要配慮個人情報」を取得する場合、あるいは個人データを第三者に提供する際には、原則として本人の同意を得ることが義務づけられています。
しかし、松本デジタル大臣が「デジタル技術がものすごい勢いで進行している」と危機感を露わにする通り、膨大なデータを学習に必要とするAI開発において、この「同意」の壁が大きなハードルとなってきました。
特に、特定の個人を識別できない形にするためのコストや手間が、国産AIの開発を阻害しているとの声が経済界からも強く上がっていたのです。
過去の教訓とデータの利活用
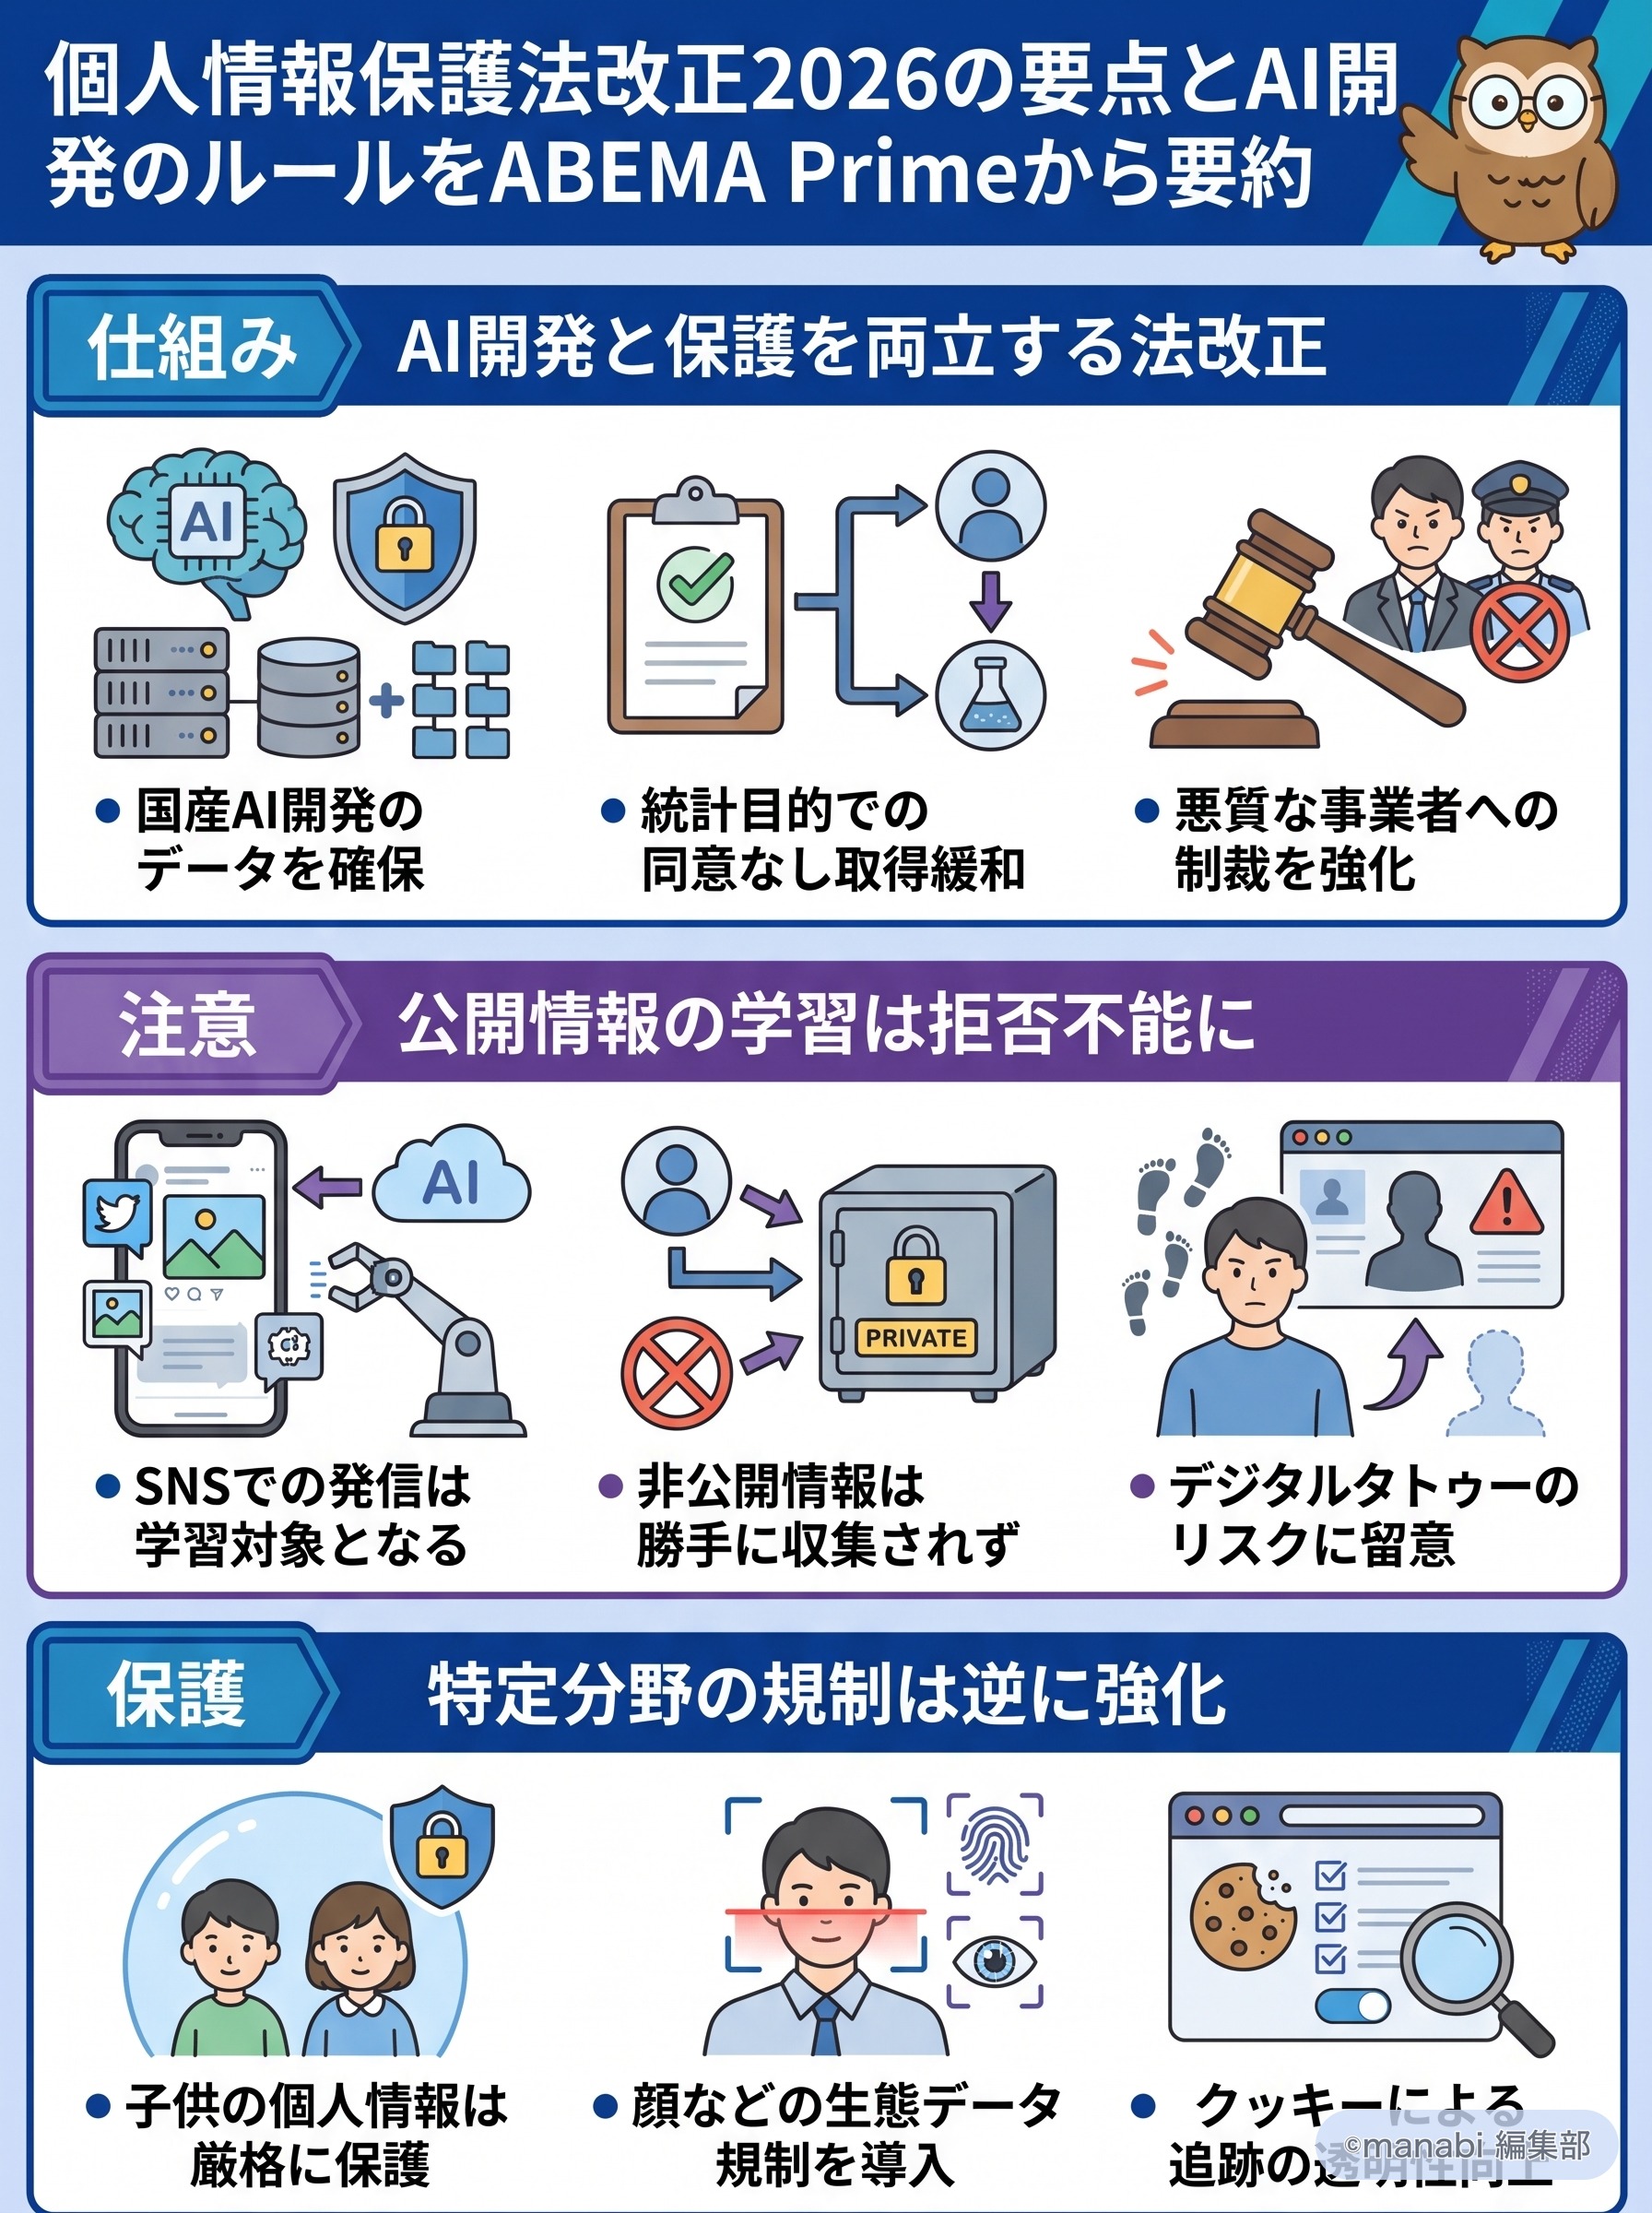
今回の改正案の核心は、統計情報の作成やAIの学習に利用する場合に限り、特定のプロセスにおいて本人の同意を不要とする規制緩和にあります。
ジャーナリストの佐々木俊尚氏は、2003年に成立し2005年に全面施行された現在の個人情報保護法が、皮肉にも日本がAI開発で敗退した一因であると分析しています。
2010年代、電車の網棚に置き忘れられたUSBメモリから顧客名簿が流出したといったニュースが世間を騒がせ、企業側が「個人情報に触れること自体がリスク」という極端な萎縮状態に陥ってしまいました。
その結果、米国や中国がビッグデータを活用してAIを飛躍的に進化させる一方で、日本はデータの利活用において大きく出遅れることになったのです。
経済安全保障と国民の懸念
改正案は、単なる緩和だけではなく「守り」の側面も持っています。
松本大臣は「いかにAIに正確なデータを学習させるかが重要」と述べており、精度の高い国産AIを育成することが日本の経済安全保障に直結するという認識を示しました。
一方で、ネット上では「望んでいないのに勝手に個人情報を収集されるのは気持ち悪い」「保護を謳いながら、実際には利活用のしやすさを優先しているのではないか」といった懸念の声が根強く存在します。
AI開発のための利用がどこまで許容され、どのようなリスクがあるのかを、自民党の塩崎彰久議員らと共に深掘りしていく必要があります。
「攻め」の規制緩和と「守り」の課徴金制度
エージェントAI時代のデータ品質
今回の改正案において、注目すべきは規制のメリハリです。
自民党のデジタル社会推進本部でAI・Web3小委員会の事務局長を務める塩崎彰久衆議院議員は、AI開発のパラダイムシフトについて言及しています。
これまでの3年間はチャットGPTに代表される大規模言語モデルの時代でしたが、現在は「エージェントAI」へと移行しています。
これはAIが人間に代わって契約を結んだり、自律的に情報を探索したりする存在になることを意味します。
この段階では、モデルの大きさよりも「データの質」がAIの性能を左右するため、良質なデータをいかに確保するかが法改正の目的となっているのです。
規制のメリハリと新たな罰則
- 規制緩和のポイント
統計目的であれば同意なしで要配慮情報の取得が可能。
例えば、工場で製品の劣化を検知するAIを作る際、部品データに混じった個人情報を「魚の骨を抜くように」一つひとつ取り除く手間を省き、学習に役立てることができます。
- 規制強化のポイント
子供の個人情報や、顔の特徴量といった生体データ、さらにはクッキーに紐づく閲覧履歴などへの規制が新たに提案されています。
- 罰則の刷新
お金儲けのために悪質なデータの収集・提供を行う事業者に対し、新たに違反行為で得られた利益に相当する額を没収する課徴金制度を導入し、抑止力を格段に高めます。
統計データの運用における懸念
弁護士の森亮二氏は、今回の法改正を「利活用と保護の両面から評価できる」としながらも、法執行の手段としての課徴金の導入が重要であると指摘します。
しかし同時に、企業が「統計データ」として扱う情報が、本当に個人の権利を侵害しないのかという点に強い懸念を示しています。
例えば、あるデータが「まるまる区在住の20代男性の犯罪歴」といった粒度で統計化された場合、分母が少なければ実質的に個人を特定できてしまう「名ばかり統計」になりかねません。
こうした運用の穴をどう塞ぐかが、今後の詳細なルール作りの焦点となるでしょう。
SNS発信者が直面する「デジタルタトゥー」の現実
公開情報の学習利用という現実
番組に出演したYouTuberのジェシカさんとmomohahaさんは、「自分たちのプライベートな発信がどこまで抜かれているのか」という切実な不安を口にしました。
これに対し塩崎議員は、「自ら公表している情報」については同意なく学習に利用される可能性があるという衝撃的な事実を明かしました。
例えば、YouTube動画の中で「最近風邪を引いてしまった」と発言した場合、それは「病歴」という要配慮個人情報に該当しますが、本人が自発的に公開しているため、AIの機械学習に活用される対象となり得ます。
一方で、秘匿している住所や電話番号などが勝手に抜かれることは、現在の法体系でも今回の改正案でも想定されていません。
| 情報の分類 | 収集の可否 | 注意点 |
|---|---|---|
| 公開された要配慮情報 | 同意なしで学習利用可 | YouTubeでの病歴発言など、本人が発信した内容は学習対象になる可能性がある。 |
| 非公開の個人情報 | 原則として同意が必要 | 誰にも言わず、秘匿している情報は勝手に収集・学習されることはない。 |
| 検索履歴・クッキー | サービス提供者が把握 | 検索履歴そのものは直接的な個人情報ではない場合もあるが、別ルールの管理下にある。 |
デジタルタトゥーの永続的なリスク
SNSで日常をさらけ出すことが仕事の一部となっているインフルエンサーにとって、この現実は重い意味を持ちます。
ジェシカさんは「出したものは仕方ないと思っていたが、データとして永続的に使われるとは考えていなかった」と述べました。
特に10代の若者が、リテラシーが不十分なまま自宅の前で踊る動画を公開したり、本名を教え合ったりする行為は、取り返しのつかないリスクを孕んでいます。
一度AIの学習モデルに組み込まれてしまえば、個別の情報を「消してくれ」と頼んでも、ブラックボックス化したAIの内部からそのデータだけを抽出・削除することは現在の技術では不可能なのです。
リテラシー・技術・規制の「3つの信頼軸」
信頼構築のための三位一体
これからのAI社会において、個人の権利を守るためには、法律という「規制」だけでは不十分です。
塩崎議員は、規制・技術的制御・リテラシーの3つの組み合わせによる立体的な信頼構築が必要だと提言しています。
規制によって悪質な事業者を排除し、技術によって「個人情報が外部に出力されないようなブロッキング」を施し、そしてユーザー自身が「どの情報を公開し、どの情報を守るべきか」を判断する知恵を持つ。
この三位一体の構図こそが、安心できるデジタル社会の基盤となります。
- 1規制(Regulation)
時代に合わせた法律のアップデート。
今回の改正による課徴金制度や、子供の情報保護の強化がこれに当たります。
- 2技術的制御(Technology)
AIエージェントが暴走しないよう、技術的なフィルターをかける仕組み。
- 3リテラシー(Literacy)
自分のデータがどう扱われるかを理解し、判断する能力。
特に出し過ぎた情報のコントロールを個人で意識すること。
空間がAI化する世界での規制
佐々木俊尚氏は、昨今の「フィジカルAI」の潮流にも触れています。
ソフトバンクやホンダ、ソニーが提携して進めているように、AIは画面の中だけでなく、自動運転やロボットといった現実空間をコントロールする段階に入っています。
この「空間そのものがAI化する世界」では、私たちの行動データは意識せずとも常に収集され続けます。
ウェブサイトを閲覧する際に表示されるクッキーの同意ボタンを、多くの人が内容を読まずにクリックしてしまう現状を考えれば、「形式的な同意」の限界は明らかです。
欧州のように、同意の有無よりも「そのデータ利用が社会にどのようなインパクトを与えるか」という結果に責任を持たせるインパクト規制へのシフトも検討に値するでしょう。
今後の課題と統計データの適切な運用
統計情報の定義と透明性の確保
今回の法改正案は、AI開発を促進するアクセルと、プライバシーを守るブレーキを同時に踏むものです。
しかし、森弁護士が指摘するように、「安全な統計データ」と言い切るための基準はまだ不透明です。
統計化されたはずの情報から、逆演算によって個人の顔や名前が特定されてしまうような事態を防げるのか。
この「詰めの議論」が、これから策定されるガイドラインや下位レベルのルールにおいて極めて重要になります。
事業者が統計情報の定義を都合よく解釈し、プロファイリングによる過度なターゲティングに悪用することは、国民の不信感を増幅させるだけです。
利便性の代償とユーザーの課題
例えば、スポーツ新聞のサイトでサッカーの結果を見ているだけで、その閲覧履歴が大量の事業者に把握され、広告に活用されている事実に、多くの一般ユーザーは気づいていません。
こうした「知らない間に集められる情報」と、個人のプライバシー感覚の乖離をどう埋めるのか。
法改正によってデータの利活用が進む一方で、不気味な監視社会にならないための透明性が求められます。
改正案に盛り込まれた課徴金制度が、単なる「罰金」に留まらず、企業の倫理観を正す強力なインセンティブとして機能するかどうかが、今後の国産AIの命運を握っています。
私たちは、AIという強力なツールを手にする代償として、自らのデータというリソースを提供しています。
この取引が「便利でありがたい」と感じられるものなのか、それとも「勝手に抜かれて気持ち悪い」と感じるものなのか。
その境界線は、個人の主観に委ねられる部分も大きいのが現実です。
だからこそ、「利便性」の裏側にある「代償」を正しく認識することが、私たちユーザーに課せられた最大の課題といえます。
政治家、弁護士、エンジニア、そして発信者がそれぞれの立場で議論を尽くし、納得感のあるルールを構築していくことが、2026年以降の日本におけるAI活用の正念場となるでしょう。
