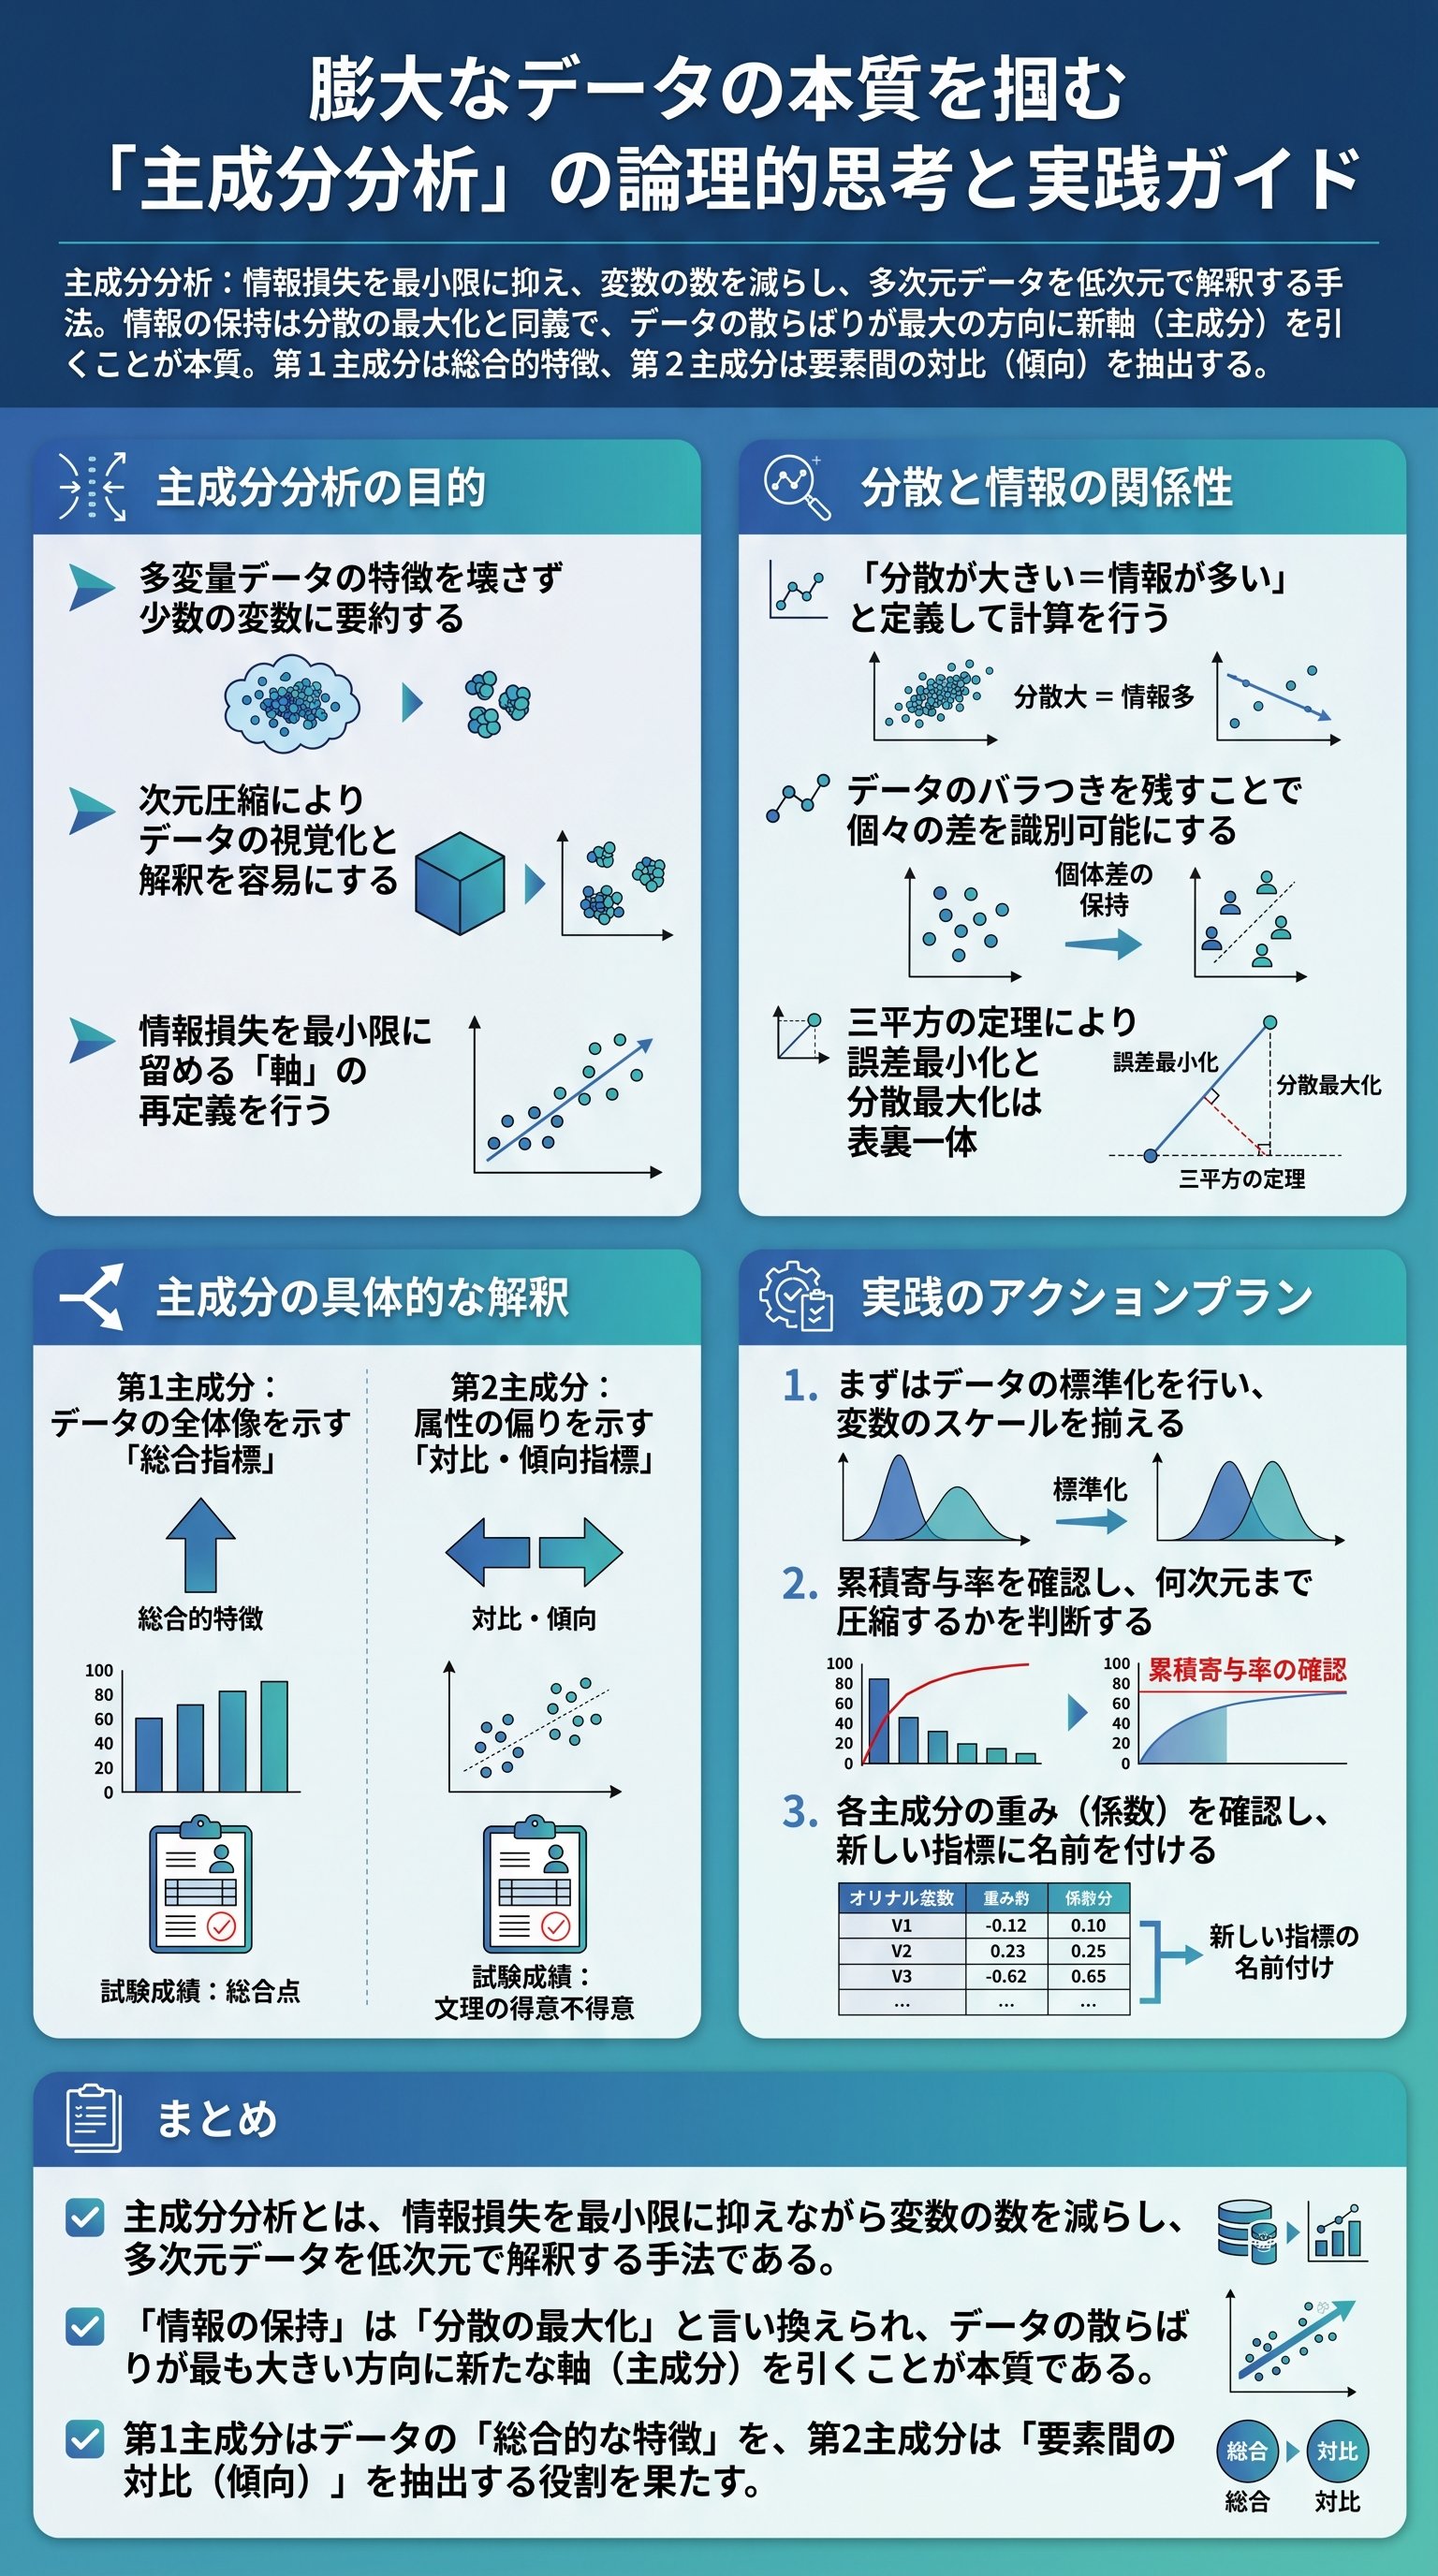
膨大なデータから「真理」を抽出する次元圧縮の正体
現代社会はデータの洪水である。
我々は日々、無数の変数に翻弄され、本質を見失っている。
だが、「主成分分析(PCA)」という武器を手にすれば、その景色は一変する。
これは単なる統計手法ではない。
複雑な世界を最小限の言葉で語り直すための「翻訳技術」である。
例えば、人間の身体を表現するのに、身長、体重、胸囲、座高……と際限なく項目を増やすのは愚策だ。
変数が多ければ多いほど、データはノイズに埋もれ、解釈の精度は落ちていく。
つまり、情報の豊かさと情報の理解しやすさは、常にトレードオフの関係にある。だからこそ、我々は「次元を落とす」という決断を迫られるのだ。
少ない変数でデータを解釈できないか。これが主成分分析の究極の到達点である。
多くの初心者は、次元を減らせば情報が失われると怯える。
しかし、現実は逆だ。
「贅肉を削ぎ落とした骨格」こそが、最も雄弁に真実を物語る。
2次元の散布図に引かれた一本の斜め線。
それこそが、多次元の闇を照らす一筋の光となる。
我々は、無駄な変数を捨て去る勇気を持たねばならない。
主成分分析が目指すのは、データの「重心」を捉え、そこから新たな軸を定義することだ。
身長と体重という2つの情報から、「体格」という1つの新しい指標を作り出す。
これによって、我々は2つの数字を追いかける労力から解放される。
複雑な事象を、たった一つの「主成分」で語るエレガンス。これこそが数学の醍醐味である。
| 項目 | 生のデータ(高次元) | 主成分分析後のデータ(低次元) |
|---|---|---|
| 変数の数 | 膨大で処理が困難 | 最小限で本質的 |
| 解釈のしやすさ | 複雑で直感に反する | 明快で構造的 |
| ノイズの量 | 非常に多く混入する | フィルタリングされ減少する |
実は、この手法はバイクのアクセルを捻るような快感を伴う。
数学的な美しさと、実用的な鋭利さが共存しているからだ。
情報の損失を最小限に抑えつつ、変数を削る。この一見矛盾した要求を完璧に満たすロジックを、これから紐解いていく。
自分の扱っているデータが「変数の多さ」によって窒息していないか、今すぐ確認せよ。
「分散の最大化」こそが情報を守り抜く唯一の盾である
なぜ、新しい軸を引く際に「分散」に注目するのか。
結論から言えば、「分散の大きさ」こそが「情報の保有量」そのものだからである。
データが一点に固まってしまえば、そこから個別の特徴を読み取ることは不可能だ。
つまり、散らばっていること自体が、データが持つ生命線なのだ。
我々が新しい軸(主成分)を引くとき、最も警戒すべきは「情報の消失」である。
元々のデータが持っていた個性が、射影(プロットの投影)によって潰れてしまうこと。
これを防ぐためには、データのばらつきが最も激しい方向に軸を定めるしかない。
理屈は単純だ。
最も広がっている方向に線を引けば、投影後のデータも最も広がるからである。
ここで、数学的な証明を導入しよう。
三平方の定理である。
原点からデータ点までの距離の二乗(斜辺)は、新しい軸上の距離の二乗(底辺)と、失われる情報の二乗(高さ)の和に等しい。
原点からの距離は不変である。
だとすれば、「失われる情報」を最小にするには、「軸上の距離(分散)」を最大にするしかない。この圧倒的な必然性こそが、主成分分析の論理的支柱である。
- 1元のデータから重心(平均)を求める
- 2重心を通る新しい軸を「仮に」引いてみる
- 3各データ点からその軸へ垂線を下ろす(射影)
- 4軸上でのデータの「散らばり具合(分散)」を計算する
- 5その分散が「最大」になるように軸の角度を微調整する
分散を最大化する。
この一見ドライな計算の裏には、「データの声を最大限に響かせたい」という数学者の情熱がある。
単に計算ソフトを回すだけでは、この「気持ち」は理解できない。
なぜその方向に線が引かれたのか。
それは、そこが最もデータの多様性が保存される場所だったからだ。
我々は、数式を通じてデータの魂を守っているのである。
主成分分析とは、データの「叫び」を最もよく拾い上げるマイクの設置場所を探す作業だ。
ノイズに惑わされず、最も大きな音(分散)を立てている方向にマイクを向ける。
そうすることで、我々は初めて、多次元の喧騒の中から真実のメロディを聴き取ることができる。
これこそが、情報を扱う者が持つべき「矜持」である。
標準化という儀式:不公平なデータを平坦化せよ
主成分分析を始める前に、避けては通れない「神聖な儀式」がある。
それが「標準化(スケーリング)」である。
もしこれを怠れば、分析結果は嘘にまみれ、無価値なガラクタへと成り下がる。
なぜなら、単位の異なる変数をそのまま比較することは、林檎とゴリラを比べるようなものだからだ。
例えば、身長(cm)と体重(kg)を考えてみよう。
数値の大きさだけを見れば、身長の方が圧倒的に大きな値を取りやすい。
だが、数値が大きいという理由だけで、身長が「重要な変数」だと判断して良いはずがない。
単位の壁を破壊し、すべての変数を同じ土俵に立たせること。それが標準化の本質だ。
「データの中心化と分散の基準化。この二段構えが、分析の公平性を保証する。」
標準化のステップは極めて明快である。
まず、すべてのデータから平均値を引き、中心を「0」に持ってくる(中心化)。
次に、それぞれのデータを標準偏差で割り、分散を「1」に統一する(基準化)。
これにより、データの散らばり具合が「相対化」され、純粋な相関関係だけが浮き彫りになる。
- 1各変数の平均値を算出し、全データから差し引く(平均0化)
- 2各変数の標準偏差を算出し、全データを除算する(分散1化)
- 3全ての変数が「同じ重み」で主成分の選定に参加できる状態にする
- 4偏見のない、真っ平らな視点で分析を開始する
もし標準化を行わなければ、数値のスケールが大きいだけの変数が、主成分を不当に支配してしまう。これは統計学における「強者の横暴」である。
スケールというノイズを取り除いた後に残るもの。それこそが、変数の真の価値である。
主成分分析の美しさは、この「平坦化」の後に訪れる。
すべてが同じ重みで扱われる世界で、それでもなお突出してくる方向。
それこそが、データの構造を支配する「真の支配者」なのだ。
標準化という儀式を経て初めて、我々はデータの真髄に触れる資格を得る。
第1主成分と第2主成分が暴く「隠れた構造」の真実
いよいよ、分析の結果得られる「主成分」の正体を暴く。
多くの場合、第1主成分はデータの「総合力」を表す指標として現れる。
例えば5教科のテスト結果を主成分分析にかければ、第1主成分は間違いなく「学力の総合偏差値」になるだろう。
全教科の点数をバランスよく統合した、最も情報の密度が高い「王の軸」である。
しかし、第1主成分だけでは、データの深淵は覗けない。
そこで登場するのが、第1主成分と直交する「第2主成分」である。
第1主成分が「量」を表すなら、第2主成分は往々にして「質」や「傾向」を表す。
テストの例で言えば、「文系が得意か、理系が得意か」という対比(コントラスト)が抽出されるのだ。
「第1主成分は『光』であり、第2主成分は『影』の輪郭を映し出す。」
この「対比」こそが面白い。
第1主成分では「高い点数を取っている」という事実だけが称賛される。
だが第2主成分は、「数学は高いが国語は低い」といったデータの偏りを鋭く指摘する。
この2つの軸を組み合わせることで、我々は初めて「そのデータが何者であるか」を立体的に理解できる。
| 主成分 | 役割 | 典型的な意味(テストの例) |
|---|---|---|
| 第1主成分 | 情報の最大抽出 | 総合的な実力・ボリューム |
| 第2主成分 | 残差情報の最大抽出 | 特徴の偏り・タイプ別分類 |
| 第3主成分以降 | 微細な差異の抽出 | 特殊な例外・ノイズに近い情報 |
主成分分析の重み(係数)を確認することは、データの遺伝子を解析する作業に似ている。
第2主成分において、文系科目の係数が「正」で、理系科目の係数が「負」になっていれば、
その軸は間違いなく「文理の壁」を表現している。
数式が勝手に、人間が定義する前の「概念」を定義し始める瞬間。これが主成分分析の真実の恐怖であり、魅力である。
我々は今、多次元の迷宮を抜け、たった2つの軸で世界を俯瞰している。
「身長と体重」から「体格と肥満度」へ。
「5教科の点数」から「学力と文理適性」へ。
情報の次元を落とすことで、我々の理解の次元はむしろ引き上げられたのだ。
主成分分析という刃を使いこなせ。
それは、混沌としたデータの中に「意味のある秩序」を彫り出す彫刻刀である。
余分な次元を削り、本質だけを磨き上げ、最後に残ったその軸こそが、君が信じるべき唯一の指針となる。
情報の海に溺れる時代は、今日で終わりだ。これからは、君自身が軸を引く番である。
