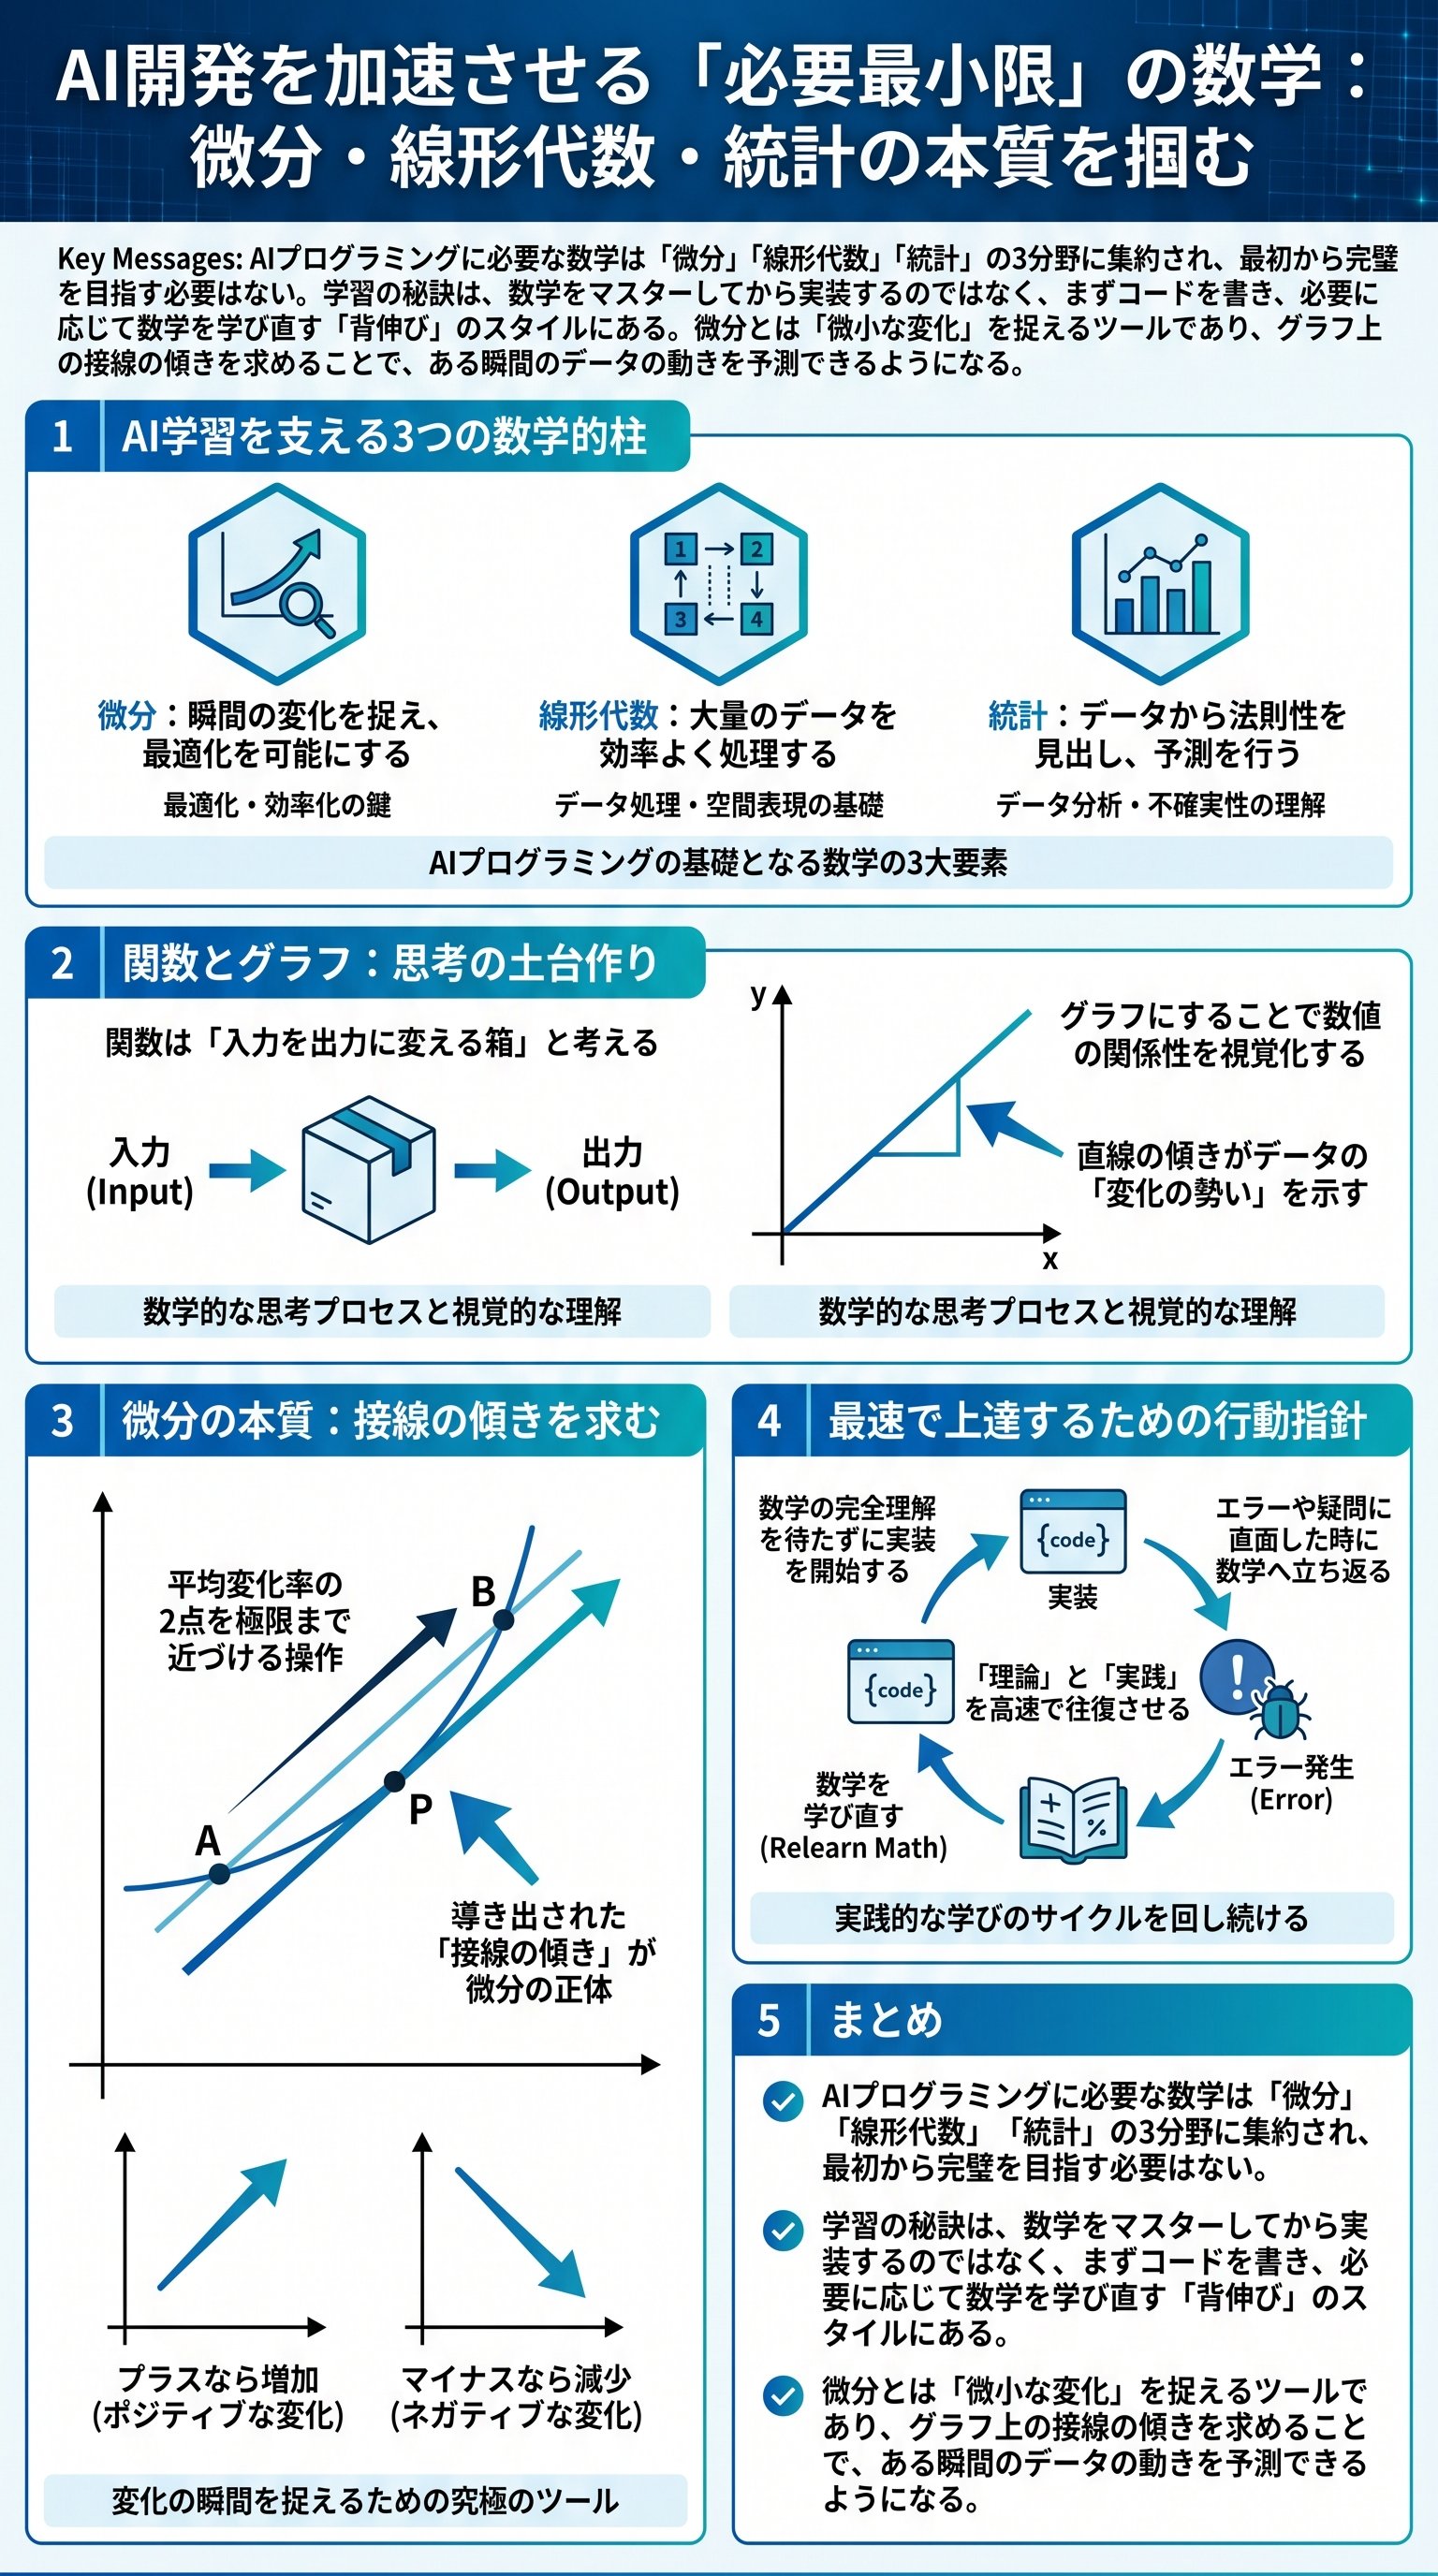
学びの順序を破壊せよ:AI数学に「完璧」は不要である
現代において、AI(人工知能)を学ぶことはもはや教養の一部となった。
しかし、多くの学習者がその入り口で「数学の壁」にぶつかり、挫折していく。
実は、その原因は彼らの頭脳不足ではない。
学習の順序が根本的に間違っているのである。
多くの者は、まず数学を完璧にマスターしてから実装に入ろうとする。
だが、それは「一生バットを振らずに、物理学で打撃理論を学ぶ」ような暴挙だ。
プログラミングの世界において、その手法は非効率の極みである。
まずはコードを書き、必要に迫られてから数学を紐解く。
この「背伸びの学習法」こそが、最短ルートを切り拓く唯一の手段なのだ。
「基礎体力を鍛えてから競技を始めるのではない。競技の中で必要な体力を悟り、鍛え直すのである。」
かつて、部員100名を抱える卓球部で未経験からレギュラーを勝ち取った者がいた。
彼は周囲が校舎の周りを走っている間、卓球場で強者と打ち合った。
体力の限界を感じてから、初めて腹筋や背筋の重要性を理解したのである。
プログラミングも同様だ。
実装の壁に直面して初めて、数学という武器の真価が理解できるのである。
では、AIという広大な海を渡るために、最低限必要な装備は何だろうか。
それは「微分」「線形代数」「統計」の3つに集約される。
これらさえ押さえておけば、AIのアルゴリズムの深淵を覗く準備は整う。
余計な寄り道は必要ない。
我々は最短距離で本質を射抜く必要があるのだ。
| 学習フェーズ | 従来のスタイル | 推奨する「背伸び」スタイル |
|---|---|---|
| 初期段階 | 教科書を1ページ目から解く | とにかくAIのコードを動かす |
| 数学の扱い | 理論を完璧に証明する | 数学的概念の「イメージ」を掴む |
| 実装のタイミング | 全ての知識が揃ってから | 分からないまま実装し、後で調べる |
今の時代、実装するための環境はかつてないほど整っている。
数年前なら数週間かかった処理が、今では数行のコードで完結する。
だからこそ、数学の沼にハマって沈没するのは時間の無駄である。
数学はあくまで、AIという建築物を支えるための「土台」に過ぎない。
その土台の美しさを愛でるのではなく、その上に何を建てるかに注力すべきなのだ。
微分が捉える「刹那の変化」:最適化の羅針盤
AIが学習するプロセスにおいて、最も重要な役割を果たすのが「微分」である。
微分と聞くだけで身構える者がいるが、恐れる必要は一切ない。
その本質は、驚くほどシンプルだ。
すなわち、「ごく小さな変化を捉えること」である。
微分を理解する第一歩は、「関数」という装置の仕組みを知ることだ。
関数とは、ある数値を入力すると、特定の規則に従って別の数値を吐き出す変換器である。
数学ではこれを $f(x)$ と表記するが、これは中身の見えない「箱」だと思えばよい。
この箱の中身が、入力を2倍にするのか、2乗にするのか。
その「変換の癖」を暴くのが数学の役割なのである。
関数とは「数の変換装置」であり、AIにおいては「入力データ」を「予測結果」へと変換するブラックボックスである。
グラフを描いたとき、その線が描く「接線の傾き」こそが微分の正体だ。
ある瞬間の変化が、プラスに向かっているのか、マイナスに向かっているのか。
それとも、水平で変化が止まっているのか。
この情報を知ることで、我々は次に打つべき一手を判断できる。
AIはこの傾きを頼りに、自らの間違いを修正していくのである。
ここで、AI学習における最重要概念「損失関数」が登場する。
これは、AIの予測と正解がいかにズレているかを示す「スコア」だ。
AIの目的は、この損失関数の値を最小にすることである。
つまり、山の頂上から最も深い谷底へ降りる道筋を探す作業に他ならない。
ここで微分が、どの方向に進めば標高が下がるかを教えてくれるのだ。
- 1現在地での傾き(微分係数)を計算する。
- 2傾きが負なら、右(値を増やす方向)へ進む。
- 3傾きが正なら、左(値を減らす方向)へ進む。
- 4傾きがゼロになる地点、すなわち「谷底」に到達する。
これが「勾配降下法」と呼ばれる、AI学習の根幹をなすアルゴリズムである。
微分はこのプロセスにおいて、盲目のAIに与えられた杖のような役割を果たす。
杖を突き、地面の傾斜を確認しながら、一歩ずつ正解へと近づいていく。
この「一歩」の積み重ねこそが、知能の誕生の瞬間なのである。
微分の美しさは、それが「一瞬の真実」を切り出す点にある。
株価の変動も、体重の推移も、AIの学習曲線も。
すべての変化の裏には、微分という冷徹な計算が潜んでいる。
この力を手に入れたとき、貴様はデータの荒波の中で溺れることはなくなるだろう。
進むべき方向は、常に数式が示してくれるのである。
線形代数という言語:多次元の情報を束ねる知力
AIの内部では、膨大なデータが猛烈な勢いで処理されている。
そのデータを整理し、効率的に扱うための言語が「線形代数」である。
もし微分が「変化」を司るなら、線形代数は「構造」を司る学問だ。
具体的には、「ベクトル」と「行列」という2つの武器を使いこなすことになる。
ベクトルとは、単なる「数値のリスト」である。
例えば、明日の天気を予測したいとしよう。
そこには気温、湿度、降水量、気圧といった複数のデータが必要だ。
これらをバラバラに扱うのではなく、一つの塊としてパッケージ化したものがベクトルだ。
AIは世界を、巨大な数値の塊(ベクトル)として認識しているのである。
そして、このベクトルを変換し、操作するのが「行列」の役割だ。
行列は、複数のベクトルを束ねた巨大な格子の形をしている。
一見するとただの数字の羅列だが、これは「情報を変換する装置」そのものだ。
ある情報を入力し、別の情報へと出力する際、行列がその橋渡しを行う。
AIのニューラルネットワークとは、実のところ「巨大な行列計算の連鎖」に過ぎない。
入力ベクトル(特徴量) × 重み行列 = 出力ベクトル(予測値)
この「重み行列」を調整することこそが、AIの「学習」の正体である。
行列の掛け算は、慣れるまでは非常に奇妙で、複雑に感じるだろう。
行と列を組み合わせ、積の和を求めるそのプロセスは、一見非効率に思える。
しかし、この独自のルールこそが、多次元の情報を一瞬で処理する魔法なのだ。
何万というデータポイントを同時に変換するには、この計算手法が不可欠なのである。
| 要素 | 特徴 | AIにおける役割 |
|---|---|---|
| スカラー | 単一の数値 | 学習率、損失の値など |
| ベクトル | 1列の数値群 | 1つのデータ(画像や音声) |
| 行列 | 数値の格子 | データの変換器、ニューラルネットワークの層 |
- 1入力層でデータを受け取る(ベクトル化)。
- 2中間層で重みを掛ける(行列計算)。
- 3活性化関数で非線形性を加える。
- 4出力層で結果を出す(予測)。
このプロセスにおいて、線形代数は計算を驚異的に簡略化する。
数百行に及ぶ複雑な方程式を、わずか1行の行列式で表現できるのだ。
この簡潔さこそが、大規模なディープラーニングを可能にした。
線形代数を知らぬ者は、AIの設計図を読み解くことができないのである。
データがベクトルとして空間に配置されたとき、そこには意味が生まれる。
近い位置にあるベクトルは似た意味を持ち、遠いものは異なる意味を持つ。
我々人間が言葉のニュアンスを感じ取るように、AIは空間内の距離で意味を解釈する。
この美しい論理の世界を支えているのが、線形代数という名の礎なのだ。
統計学が導く最適解:データに「意志」を与える
AIが扱うのは、常に不確実な「生きたデータ」である。
そのノイズだらけの山から、真実を抜き出す技術が「統計学」だ。
統計学とは、冷徹な数字に「物語」を語らせるための手法である。
我々がデータを眺める際、平均だけを見て満足するのは素人の仕業だ。
まず理解すべきは、平均という情報の脆さである。
平均値が同じでも、データの散らばり具合(分布)が違えば、その意味は全く異なる。
そこで登場するのが、「分散」と「標準偏差」だ。
これらは、データが平均からどれだけ「浮気」をしているかを示す指標である。
ばらつきが小さければデータは信頼でき、大きければ予測は困難を極める。
平均(Mean):データの中心点
分散(Variance):ばらつきの度合い(2乗の平均)
標準偏差(Standard Deviation):現実的な尺度のばらつき(分散の平方根)
さらに、2つのデータの関係性を暴く「共分散」の概念が重要だ。
例えば、「勉強時間」が増えれば「テストの点数」も上がる。
こうした相関関係を、統計学は数値で明確に定義する。
プラスの相関、マイナスの相関、あるいは無相関。
AIはこの相関関係の糸口を見つけ出し、予測の精度を高めていくのである。
ここで、ある奇妙なエピソードを紹介しよう。
ある男が自由研究で、「友人の数」と「円周率の暗記桁数」の相関を調べた。
結果は驚くべきことに、強い「負の相関」を示したのである。
すなわち、円周率を覚えるほど友人が減る、あるいはその逆という事実だ。
統計学は時として、我々が目を背けたくなるような不都合な真実を突きつける。
- 1データを収集する(生データ)。
- 2平均と分散を算出し、データの傾向を掴む(要約統計量)。
- 3データの関係性を分析する(相関・回帰分析)。
- 4未知のデータに対する予測モデルを構築する。
統計学を学ぶことで、貴様は「なんとなく」の推測を卒業できる。
「おそらくこうなるだろう」という予感を、「〇〇%の確率でこうなる」という確信に変える。
AIが導き出す予測値の裏には、常にこの統計的な裏付けが存在するのだ。
データを制する者は、未来を制すると言っても過言ではない。
データは嘘をつかないが、解釈を誤れば嘘を語り出す。
統計学を武器に持つ者は、数字に惑わされることなく、その本質を貫き通すことができる。
AIという巨人を手なずけるには、この「データの意志」を読み解く力が必要だ。
無機質な数値の羅列から、価値あるインサイトを抽出せよ。
未来を実装する者たちへ:理論と実践の幸福な結婚
さて、ここまで「微分」「線形代数」「統計」の3つを概観してきた。
これらはAIプログラミングという塔を支える三本柱である。
だが、冒頭でも述べた通り、これらを完璧に理解してから進む必要はない。
数学は「学ぶ」ものではなく、必要に迫られて「使う」ものだからだ。
もし貴様が今、数学の難解さに足踏みしているなら、今すぐペンを置け。
そして、キーボードを叩き始めろ。
実際にAIを動かし、予測が外れる悔しさを味わえ。
なぜ外れたのか、どうすれば精度が上がるのか。
その問いの答えを探すとき、数学は「血の通った知識」として貴様の力になる。
まずはGoogle Colabなどの環境で、既存のAIモデルを動かしてみよ。
そして、数式の一つひとつがコードの中でどう表現されているか、その「対応関係」を確認せよ。
現代には、独学の限界を突破するための優れたプラットフォームも存在する。
専門家によるメンタリングや、実務に即したカリキュラムは、独学の迷走を防ぐ。
恥を忍んで人に頼ることも、賢明な戦略の一つである。
「分からない」ことを恥じるな。
解決しようとしない姿勢こそを恥じよ。
AI数学は、高校レベルから大学1年レベルの知識で十分通用する。大切なのは公式の暗記ではなく、概念がAIの挙動とどう結びついているかという「納得感」だ。
最後に、私の座右の銘を贈ろう。
「知ることは、変わることである。」
数学というレンズを通して世界を見れば、データの景色は一変する。
ノイズの嵐だったものが、意味を持った美しい旋律へと変わるはずだ。
その感動を味わう権利は、最初の一歩を踏み出した者にのみ与えられる。
3ヶ月以内に、自分の手で実装したAIモデルを一つ完成させる。
数学への苦手意識を捨て、それを「最強の味方」へと変えること。
道のりは険しいかもしれない。
だが、その先には誰も見たことのない景色が広がっている。
AIという時代の潮流に乗り、自らの手で未来を書き換えろ。
貴様の挑戦を、私は冷徹かつ熱烈な期待を込めて見守っている。
今、この瞬間から、貴様の学びは真の覚醒を迎えるのだ。
