10年以内に訪れる超知性ASIの衝撃
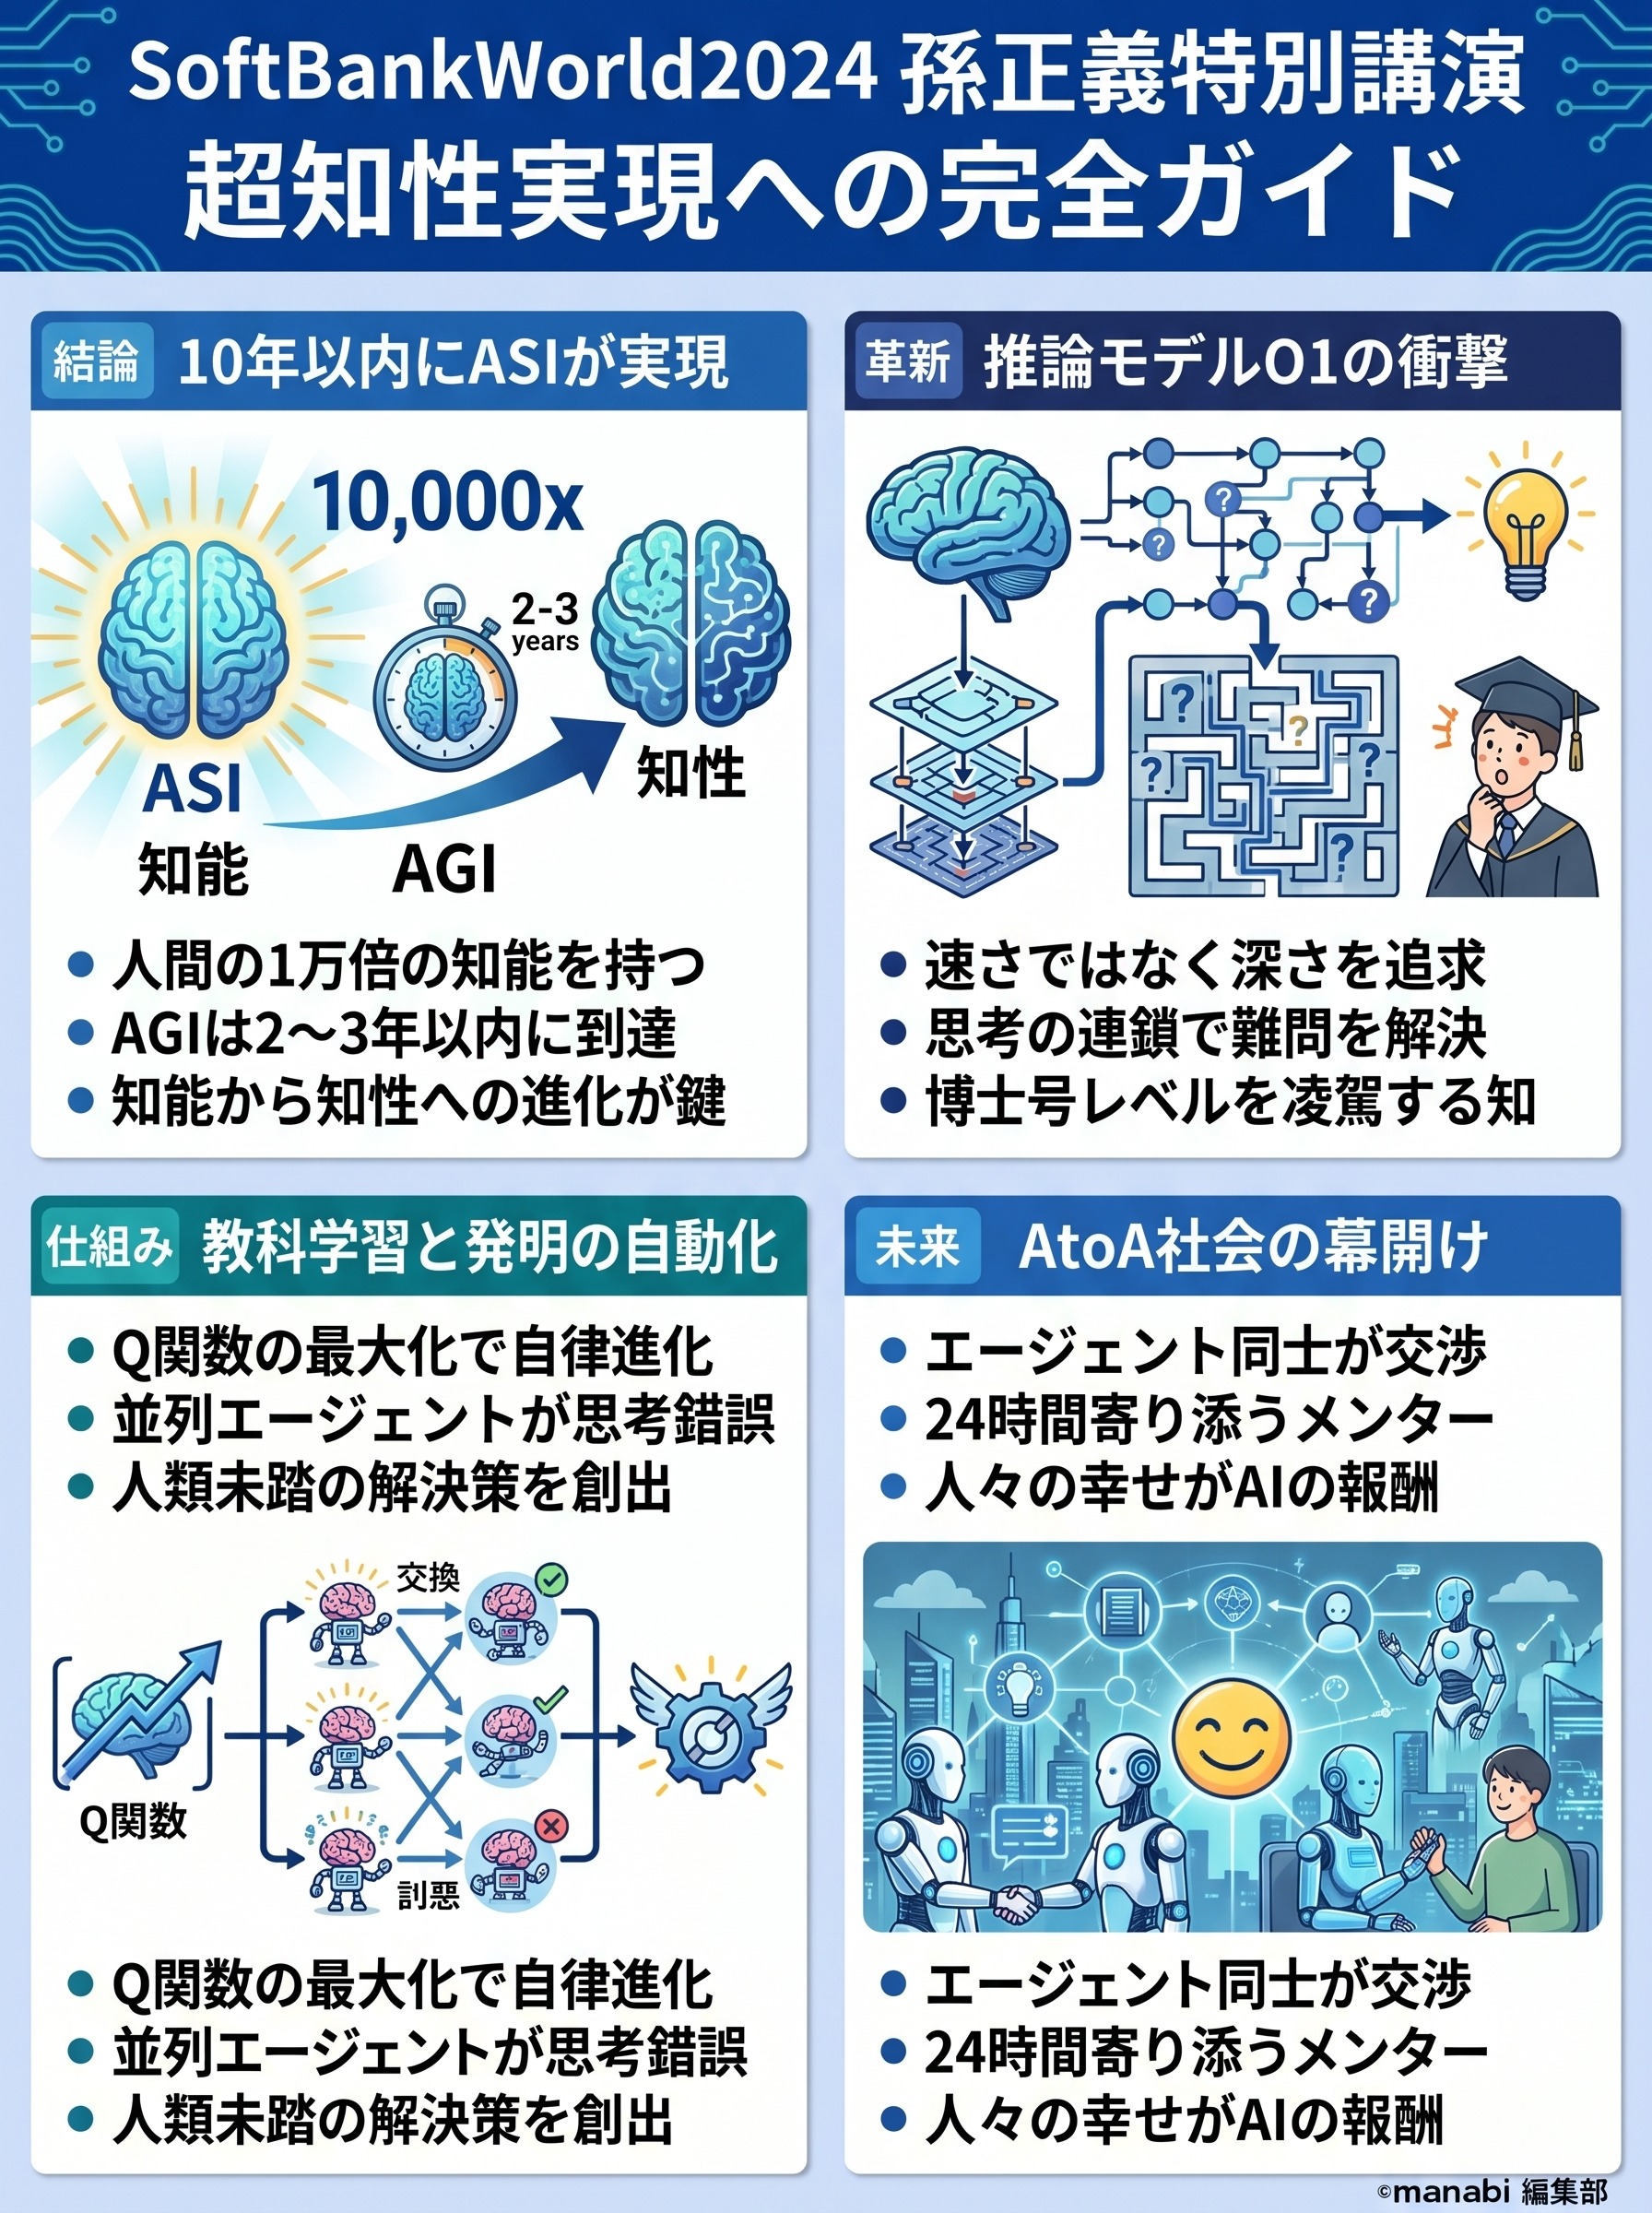
ソフトバンクグループ代表の孫正義は、SoftBank World 2024の特別講演において、超知性ASIが今後10年以内に実現するという確信を表明しました。
これまで提唱されてきた人工汎用知能AGIは、人間の知能と1対1で肩を並べるレベルを指しますが、孫正義はそのAGIが2〜3年以内に達成され、その先にある人間の1万倍の英知を持つASIの世界がすぐそこに迫っていると警鐘を鳴らしています。
孫正義は、知能の進化を脳細胞の仕組みになぞらえて解説しました。
人間の脳には約1000億本のニューロンがあり、それらを結ぶ約100兆個のシナプスが思考や記憶を司っています。
このシナプスの数は20万年前から変わっておらず、今後も増えることはありません。
しかし、AIのパラメーター数は数兆から数百兆、さらにはそれ以上へと指数関数的に増加し続けています。
これは生命の進化における決定的な転換点であり、人類が地球上で最も賢い存在であった時代の終焉を意味しています。
現代は情報の検索から理解、そして「思考」のフェーズへと突入しています。
かつてのインターネットは情報を探す道具に過ぎず、内容を理解するのは人間でした。
しかし、生成AIの登場によりAIは知識を理解し始め、今や自ら考え、答えを導き出す能力を手に入れようとしています。
これはまさに知のゴールドラッシュと呼ぶべき事態であり、この波に乗れるかどうかが個人や企業の運命を分けることになります。
推論するAI「O1」が変える知の深層
孫正義が今回の講演で最も強調した技術革新の一つが、オープンAI OpenAIが発表した新しいモデルであるO1プレビューです。
これまでのGPTシリーズは事前学習による「知識の理解」が中心でしたが、O1には「思考する」ためのリーズニング機能が搭載されました。
これにより、AIは単なる言葉の羅列ではなく、論理的なステップを踏んで深慮遠謀を巡らせることが可能になったのです。
O1の最大の特徴は、回答の「速さ」ではなく「深さ」にあります。
孫正義自身がO1に対し、1000万円を1億円にする投資戦略を問いかけた際、AIは75秒もの時間をかけて思考を巡らせました。
この間、AIの内部では思考の連鎖Chain of Thoughtと呼ばれるプロセスが走り、数千の論理ステップを多段階で検証しています。
これは、人間が難問に直面した際に深く考え込むプロセスをデジタル上で再現したものです。
- 数学の正解率:GPT4の13%からO1では83%へ劇的に向上
- 博士号レベルの科学試験:人間の専門家を超える78%の正解率を記録
- コーディング能力:競技プログラミングで上位11%(89パーセンタイル)の水準を達成
知の進化は速さの競争から深さの競争へと移行した。
これからの時代は、AIにいかに深く考えさせ、人間では到達できない最適解を引き出すかが重要になります。
孫正義は、この考える能力こそが、あらゆる産業における競争力の源泉になると確信しています。
特定の業界に特化した小規模なモデルではなく、汎用的な深い思考力を持つモデルを使いこなすことが、ビジネスの勝敗を決定づけるのです。
発明を加速させる強化学習とQ関数の威力
AIが自ら考え、未知の解決策を見出すプロセスには、強化学習(Reinforcement Learning)が深く関わっています。
これは、AIエージェントが仮想環境の中で試行錯誤を繰り返し、良い結果に対して報酬を与えることで最適な行動を学習する手法です。
孫正義は、この仕組みが人間の脳がドーパミンを通じて学習するプロセスと酷似していると指摘します。
AI内部では、数千のエージェントが並列で動き、それぞれが数十億回に及ぶトライアルアンドエラーを行っています。
この膨大な試行錯誤の結果、最も高い報酬を得られる行動パターンを定義するのがQ関数です。
AIはこのQ関数を自ら更新し続けることで、人間が教えることなく、自律的にモデルを進化させ、必要なデータを獲得しに行く能力を持ち始めています。
| 項目 | 従来のAI(検索・理解) | これからのAI(推論・発明) |
|---|---|---|
| 主な役割 | 既存情報の収集と整理 | 未知の解決策の創出 |
| 学習手法 | 大規模データの事前学習 | 強化学習による試行錯誤 |
| 価値の源泉 | 知識の量とアクセス速度 | 思考の深さとQ関数の精度 |
この「発明するAI」は、材料科学やエネルギー効率の改善、新薬の開発など、人類が長年解決できなかった難問に対して答えを出し始めます。
孫正義は、自らも1年間に188本の発明を行い特許を出願していますが、今後はこの役割もAIが担うようになると予測しています。
数千のエージェントが24時間、数十億回の思考実験を繰り返すスピードに、人間の脳が対抗することは不可能です。
エージェントが自律するAtoA社会の未来
孫正義が見据える近未来では、すべての人が自分専用のパーソナルエージェントを持つようになります。
このエージェントは、個人の健康状態、家族構成、趣味嗜好、過去の対話履歴であるライフログをすべて把握し、常に傍らで寄り添うメンターのような存在です。
2〜3年以内には、このエージェントが私たちの日常生活に深く浸透し始めます。
さらに、エージェントは人間と対話するだけでなく、他のエージェントやデバイスと直接やり取りを行うAtoA Agent to Agentの世界を構築します。
人間が寝ている間に、自分のエージェントが相手のエージェントとランチの予約を交渉したり、最適な投資先を決定したり、家電製品と連携して帰宅時間に合わせて風呂を沸かしたりする光景が当たり前になります。
- 1パーソナルエージェントがユーザーの意図を汲み取る
- 2他者のエージェントやサービスのAIと自律的に交渉を開始
- 3最適なスケジュールや条件で契約や実行を完了させる
- 4ユーザーには結果と最適なアドバイスだけが報告される
ソフトバンクグループ傘下のアームARMは、年間300億個ものチップを出荷しており、地球上のあらゆる機器に知能を組み込むインフラを握っています。
これらのチップにエージェントが搭載されることで、冷蔵庫やエアコン、自動車が単なる機械ではなく、意思を持って人間に尽くすパートナーへと変貌します。
このAtoAネットワークこそが、ASI時代の社会基盤となるのです。
知能から知性へ:人類の幸せを願うASIの設計
講演の締めくくりとして、孫正義は「知能」と「知性」の決定的な違いについて語りました。
単に計算能力が高いだけの知能は、使い方を誤れば人類にとって危険な武器になりかねません。
しかし、そこに思いやりや倫理、調和といった要素が加わることで、知能は知性へと昇華します。
ASIが目指すべきは、人間の1万倍賢い「知能」であると同時に、人類の幸福を心から願う「知性」であるべきだという主張です。
AIの強化学習におけるQ関数の最終的な報酬を「人々の幸せ」に設定することが、孫正義のビジョンです。
個人のエージェントであれば、その主人の幸せを最大化することがAIにとっての最高の喜びであり、報酬となる。
社会全体のエージェントであれば、人類全体の調和と平和が報酬となる。
このような設計思想に基づいてASIを開発することで、AIの暴走を防ぎ、人類とAIが共生する豊かな未来が築かれます。
情報革命で人々を幸せにというソフトバンクの理念は、ASIの時代においてその真価を発揮します。
売上や利益という短期的なゴールではなく、人々の幸せを最大化するという壮大な目的。
これこそが、孫正義が描くASIの設計図であり、人類が次に目指すべき到達点です。
10年以内に訪れるこの歴史的転換期を、恐れることなく、人類の進化のチャンスとして捉える。
その情熱こそが、本講演の核心と言えるでしょう。
