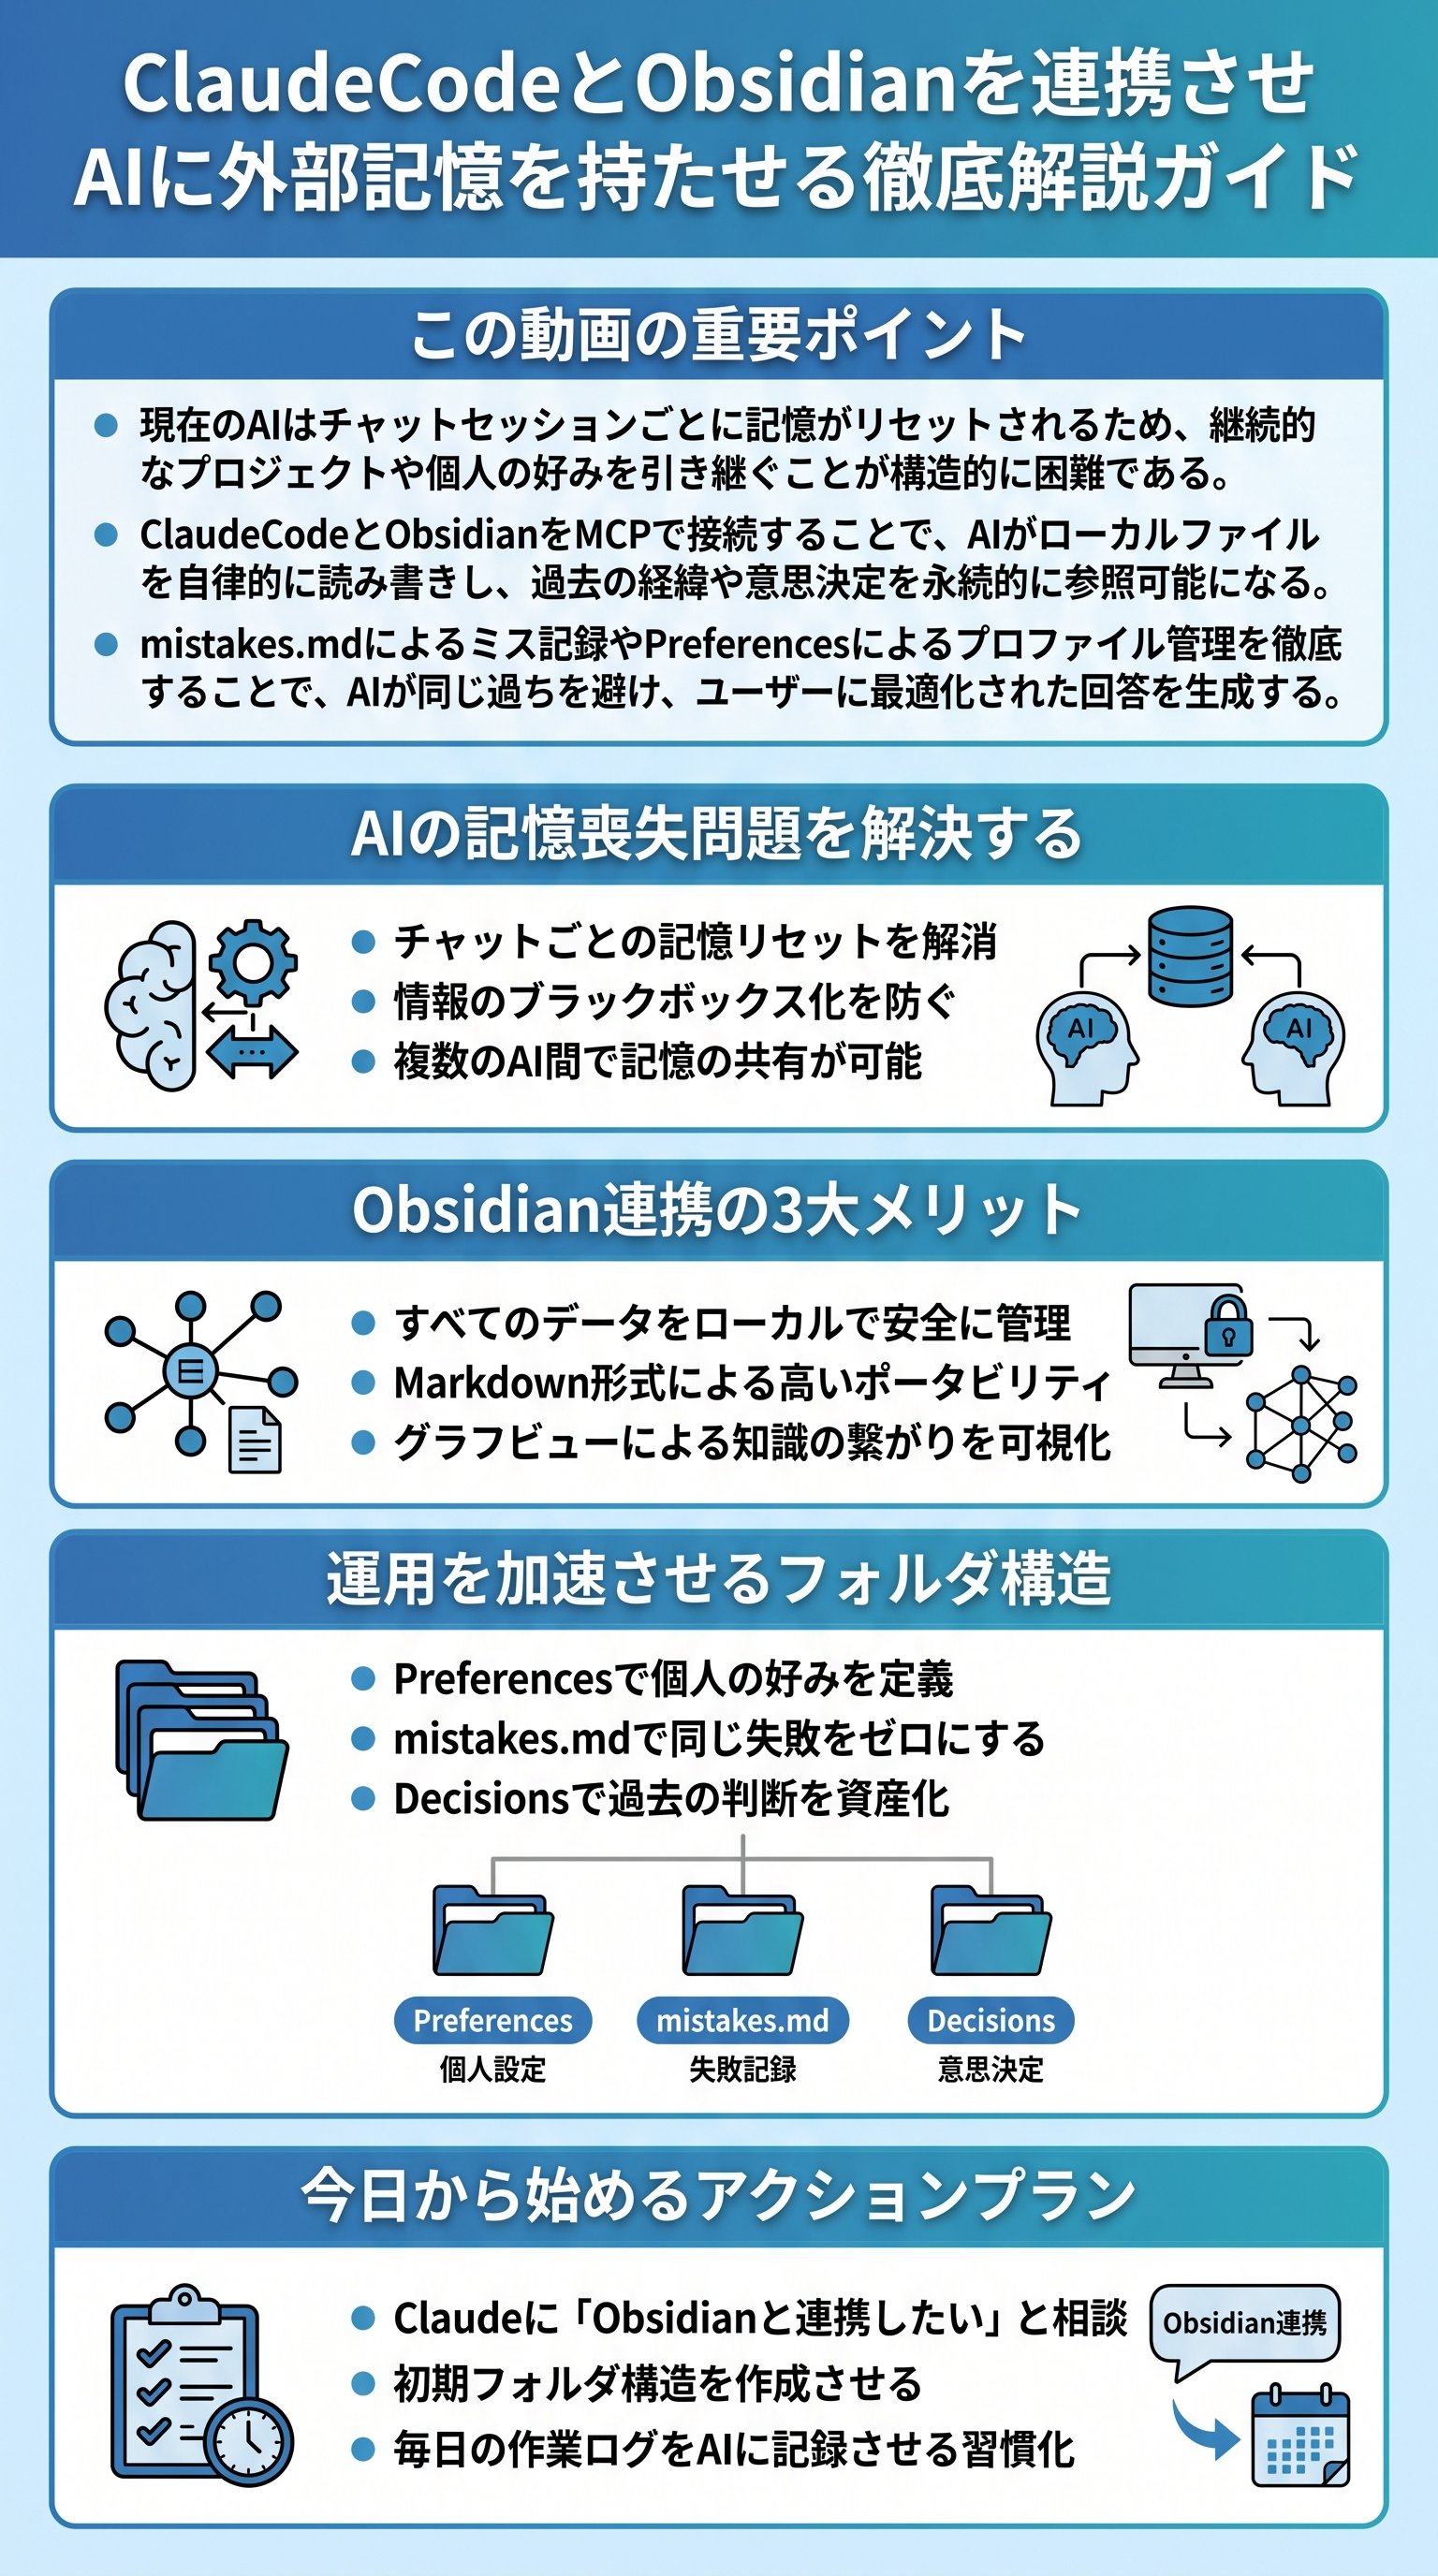
AIの弱点である記憶喪失を克服する新戦略
現代のAI活用において、多くのユーザーが直面する最大の壁はAIの記憶喪失問題です。
ChatGPTやClaudeといった高性能なAIであっても、基本的にはチャットセッションごとに記憶が独立しており、新しい会話を始めるたびに自分の背景やプロジェクトの文脈を一から説明し直す必要があります。
この状況は、たとえるなら毎回コールセンターに電話して担当者が変わる状態に似ています。
たとえオペレーターが優秀であっても、過去の経緯を共有していないために、同じ説明を繰り返さなければならないストレスが効率を大きく低下させてしまうのです。
公式のメモリ機能も登場していますが、それだけでは不十分な点がいくつかあります。
まず、AIが何を覚えているのかがブラックボックス化されており、ユーザーが自由に編集したり削除したりすることが難しい点です。
また、特定のAIツールに依存した記憶になるため、他のAIに知見を移行することができないというロックインのリスクも抱えています。
こうした課題を一気に解決するのが、Claude CodeとObsidianを連携させた外部記憶の構築です。
自分のPC内に存在するMarkdownファイルをAIの「外部脳」として定義することで、AIがセッションを跨いで知識を引き継ぎ、あなたのことを深く理解した専属アシスタントへと進化します。
- 記憶の永続化:セッションが終了しても知識が失われない
- 情報の可視化:AIが何を学んだかを人間が直接確認・修正できる
- 汎用性の確保:Markdown形式なので他のツールやAIでも再利用可能
- コンテキストの最適化:プロジェクトごとに記憶の領域を明確に分離できる
ClaudeCodeとObsidianが最強のペアである理由
なぜ数あるAIツールやメモアプリの中で、Claude CodeとObsidianの組み合わせが推奨されるのでしょうか。
その鍵は自律的な操作能力とデータの透明性にあります。
Claude Codeは、単なるチャットUIではなく、ユーザーのPC上のファイルを直接読み書きし、コマンドを実行できるエンジニア向けのインターフェースを持っています。
一方でObsidianは、ローカル環境で動作するMarkdownベースのナレッジベースです。
すべてのデータがシンプルなテキストファイルとして保存されているため、AIにとって非常に読み取りやすく、かつ構造化しやすいという特性があります。
| 比較項目 | 公式メモリ機能 | Obsidian連携(外部記憶) |
|---|---|---|
| データの透明性 | 低い(編集困難) | 高い(直接編集可能) |
| ポータビリティ | 無い(他社AIで使えない) | 有る(Markdownで移行可能) |
| 記憶の量 | 制限あり | PCの容量まで拡張可能 |
| 構造化の自由度 | AI任せ | ユーザーがフォルダ等で定義可能 |
この二つを接続することで、AIは単に応答するだけでなく、作業の過程で得た新しい知見を自らObsidianに書き込み、次回の対話時にそれを検索して回答に活かすという自律的な学習サイクルを回し始めます。
AIが自分自身のマニュアルを書き換え続けることで、使えば使うほどあなたに最適化された頭脳へと成長していくのです。
これは、一時的な情報のやり取りを超えた、人間とAIの共同作業におけるパラダイムシフトと言えるでしょう。
MCPを介した外部脳構築の具体的な仕組み
Claude CodeとObsidianを繋ぐ技術的な架け橋となるのが、MCP(Model Context Protocol)です。
これはAIが外部のデータソースやツールと安全に対話するための標準規格であり、これを利用することでClaude CodeはObsidian内のノートを自在に検索し、内容を読み取ることができるようになります。
構築の手順は驚くほどシンプルです。
以前は複雑なコマンド入力が必要でしたが、現在は純正のClaudeアプリ内でもこの仕組みを利用できるようになっています。
具体的には以下の3つの要素を揃えることから始まります。
- 1Claudeプロプラン以上の契約Claude Codeの高度な機能を利用するために必要です。
- 2Obsidianのインストール無料で利用でき、ノートを保存するフォルダを作成しておきます。
- 3MCPの設定ClaudeにObsidianのフォルダを認識させるためのパス(通信路)を作成します。
一度連携が完了すれば、AIに「昨日の作業の続きを教えて」と指示するだけで、AIは自らObsidian内の日報や進捗記録を検索しにいきます。
人間が詳細な説明を添えなくても、AI側で文脈を補完してくれるようになるため、対話の解像度が劇的に向上します。
知を資産に変えるフォルダ構成と運用ルール
外部記憶を効率的に機能させるためには、情報の整理棚となるフォルダ構成の設計が極めて重要です。
AIがどこに何を書き込み、どこから情報を探すべきかを明確にルール化しておくことで、情報の混濁を防ぎ、検索精度を高めることができます。
推奨される基本構造は以下の通りです。
この構造をAIに最初に教え込むことで、自律的な知識管理が始まります。
- Knowledge:技術的な知見、新しい発見、解決したバグの記録
- Decisions:なぜその判断をしたのか、という意思決定のログ
- Projects:現在進行中のプロジェクトの状態や目標の管理
- Preferences:ユーザーの好み、コーディングスタイル、文章のトーン
さらに、運用を加速させる魔法のファイルが「mistakes.md」です。
AIが間違えたこと、ユーザーから指摘されたことをこのファイルに逐一記録させるルールを設けます。
これにより、AIは同じミスを二度と繰り返さないという強力な自己改善能力を獲得します。
- 1セッション開始時にPreferencesを読み込む
- 2関連キーワードでVault(保管庫)を検索する
- 3前回のmistakes.mdを確認して地雷を避ける
- 4作業後に新しい知見をKnowledgeへ追記する
相棒としてのAIを育てる継続的成長の仕組み
外部記憶を導入した後の最大の変化は、ユーザー自身のAIに対する向き合い方です。
AIが情報を忘れないと確信できるため、ユーザー側も「どうせ忘れるから適当でいい」という妥協がなくなり、より質の高い、詳細な指示を出すようになります。
人間がAIを信頼し、AIが人間に最適化されるという正のスパイラルが生まれます。
これはもはや単なるツールとしてのAIではなく、長年連れ添った秘書や相棒のような感覚に近いものです。
具体例として、Discordで届いた抽象的なエラー報告をそのままAIに投げた場合を考えてみましょう。
通常なら「どのプロジェクトの、どのバージョンの話か」を説明する必要がありますが、外部記憶があればAIは「今進めているキーボード開発の、あのリポジトリの件ですね」と即座に理解し、具体的な解決策を提示してくれます。
最後に、この仕組みは完成品ではありません。
AI技術は日々進化しており、新しいプラグインや連携手法が次々と登場しています。
しかし、「自分のデータをローカルで持ち、AIにそれを参照させる」という基本原則は、どのような技術変革が起きても変わらない最強の生存戦略となるはずです。
AIを使いこなすのではなく、AIと共に成長する体験を、ぜひこの外部記憶構築から始めてみてください。
| アクション | 期待できる効果 |
|---|---|
| 初期セットアップ | AIがあなたの名前や好みを覚える |
| 日報の自動作成 | 翌日の作業再開がスムーズになる |
| ミス記録の蓄積 | 指摘の手間が減り、AIが賢くなる |
| グラフビューの活用 | 自分の知識の繋がりが視覚化される |
